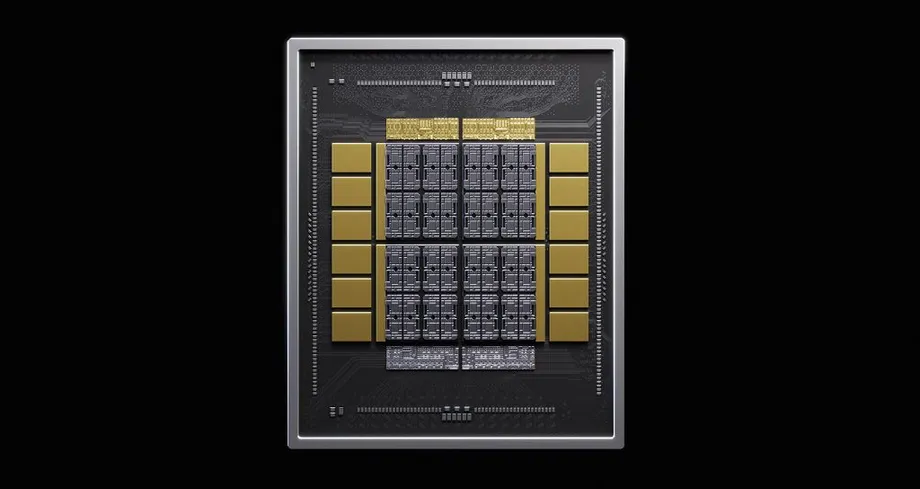
तीन मेमोरी आपूर्तिकर्ताओं के लिए साझा मैन्युफैक्चरिंग प्रक्रिया
18 अक्टूबर, 2026 को प्रकाशित उद्योग जगत की रिपोर्टों के अनुसार, Nvidia ने Samsung Electronics, SK hynix और Micron से अपनी अगली पीढ़ी की कस्टम हाई-बैंडविड्थ मेमोरी के बेस डाई के लिए TSMC की 3nm मैन्युफैक्चरिंग प्रक्रिया इस्तेमाल करने को कहा है। बताया जाता है कि Samsung के Device Solutions डिविजन ने आंतरिक समीक्षा के बाद इस अनुरोध को स्वीकार कर लिया। इससे उसका ताइवानी फाउंड्री प्रतिद्वंद्वी मेमोरी मैन्युफैक्चरिंग के उस हिस्से में शामिल होगा, जिसे Samsung पारंपरिक रूप से खुद संभालता आया है।
विषय-सूची
- तीन मेमोरी आपूर्तिकर्ताओं के लिए साझा मैन्युफैक्चरिंग प्रक्रिया
- मेमोरी स्टैक के भीतर क्या बदलता है?
- Nvidia सभी आपूर्तिकर्ताओं में एक ही प्रक्रिया क्यों चाहता है
- Samsung अपने कारखानों को भी विकल्प में रखेगा
- Micron और SK hynix के अलग-अलग रास्ते
- Nvidia के प्रदर्शन संबंधी आंकड़ों का अर्थ
- Amazon ने मेमोरी को Nvidia के व्यापक प्लेटफॉर्म से जोड़ा
- यह बदलाव कैसे सामने आया
- मुख्य बातें
NVHBM नाम का यह उत्पाद HBM4E पर आधारित है, जो हाई-बैंडविड्थ मेमोरी की सातवीं पीढ़ी है। Nvidia यह भी चाहता है कि आपूर्तिकर्ता मेमोरी डाई के लिए DRAM मैन्युफैक्चरिंग तकनीक की छठी पीढ़ी इस्तेमाल करें, जिसे 1c कहा जाता है। इसका उद्देश्य अलग-अलग आपूर्तिकर्ताओं की मेमोरी को अधिक एकसमान ढंग से काम करने देना और हर आपूर्तिकर्ता के उत्पादों को मंज़ूरी देने में लगने वाला इंजीनियरिंग काम घटाना है।
Samsung का यह फैसला पैकेजिंग अनुकूलता से आगे बढ़कर HBM मैन्युफैक्चरिंग तक TSMC के साथ उसके मौजूदा संबंध का विस्तार होगा। चार साल पहले, कंपनियों ने यह सुनिश्चित करने के लिए साथ काम किया था कि Samsung की मेमोरी TSMC की पैकेजिंग तकनीक के ज़रिये ग्राफिक्स प्रोसेसर से जुड़ सके। मेमोरी स्टैक के भीतर एक अहम चिप का उत्पादन इस सहयोग को और आगे ले जाता है।
Nvidia का प्रस्ताव बेस डाई की भूमिका भी बदलता है। NVHBM में मेमोरी कंट्रोलर, यानी डेटा के प्रवाह को निर्देशित करने वाली सर्किटरी, मुख्य प्रोसेसर से हटाकर मेमोरी स्टैक के निचले हिस्से में ले जाई जाती है। इससे बेस डाई कंप्यूटिंग सिस्टम का अधिक अहम हिस्सा बन जाता है, न कि केवल मेमोरी और प्रोसेसर के बीच का संपर्क।
Samsung के लिए इस आर्किटेक्चर को स्वीकार करने का मतलब है उन दो फैसलों को अलग करना जिन्हें वह पहले साथ रखता था: जानकारी संग्रहित करने वाली मेमोरी कौन बनाएगा और प्रोसेसर से उसके कनेक्शन को संभालने वाली लॉजिक चिप कौन बनाएगा। Samsung मेमोरी की आपूर्ति जारी रखेगा, जबकि निर्दिष्ट बेस डाई का निर्माण TSMC करेगा।
मेमोरी स्टैक के भीतर क्या बदलता है?
HBM में कई मेमोरी डाई को एक शक्तिशाली प्रोसेसर के बगल में एक-दूसरे के ऊपर लगाया जाता है। इस स्टैक्ड डिज़ाइन से बड़ी मात्रा में डेटा कम दूरी तय करता है, जिससे AI एक्सेलेरेटर की कंप्यूटिंग इकाइयों तक जानकारी पहुंचती रहती है। डाई सिलिकॉन का एक अलग टुकड़ा होता है, जिसमें इलेक्ट्रॉनिक सर्किट होते हैं।
कोर डाई डेटा संग्रहित करते हैं। बेस डाई इनके नीचे होता है और कनेक्शन तथा लॉजिक संबंधी काम संभालता है। पारंपरिक व्यवस्था में मेमोरी कंट्रोलर मुख्य एक्सेलेरेटर डाई पर रहता है। NVHBM इस कंट्रोलर को बेस डाई में स्थानांतरित करता है, जिससे प्रोसेसर पर दूसरी सर्किटरी के लिए जगह खाली होती है।
चिपों को जोड़ने के लिए Nvidia एक कस्टम फिजिकल इंटरफेस इस्तेमाल करता है, जिसे PHY कहते हैं। PHY वह सर्किटरी है जो विद्युत संकेत भेजती और प्राप्त करती है। NVHBM के तकनीकी विवरणों के मुताबिक, यह मानक HBM से जुड़े चौड़े, समानांतर इंटरफेस की जगह एक संकरे, स्वामित्व वाले सीरियलाइज़्ड कनेक्शन का इस्तेमाल करता है, जो कम कनेक्शनों के ज़रिये अधिक गति से डेटा भेजता है।
पारंपरिक इंटरफेस का आकार इस बदलाव का आकर्षण समझाता है। HBM4 में 32 चैनल होते हैं, जिनमें से हर एक 64 बिट चौड़ा होता है, यानी कुल चौड़ाई 2,048 बिट होती है। इन कनेक्शनों को संभालने के लिए चिपों के बीच काफी सर्किटरी और जटिल वायरिंग की ज़रूरत होती है। NVHBM का उद्देश्य इस बोझ को घटाना और इंटरपोज़र पर रूटिंग को आसान बनाना है। इंटरपोज़र चिपों के नीचे की वह परत है जो उन्हें जोड़ती है।
Nvidia, NVLink Fusion के ज़रिये कस्टम सिलिकॉन पार्टनरों को NVHBM एक बिल्डिंग ब्लॉक के रूप में दे रहा है। मानक HBM एक अलग उत्पाद श्रेणी बना रहेगा। NVHBM चुनने वाले पार्टनर अपने एक्सेलेरेटर सिस्टम में Nvidia के निर्दिष्ट कंट्रोलर और कनेक्शन डिज़ाइन का इस्तेमाल करेंगे।
Nvidia सभी आपूर्तिकर्ताओं में एक ही प्रक्रिया क्यों चाहता है
Nvidia की प्रस्तावित मैन्युफैक्चरिंग योजना में मेमोरी लेयर के लिए उन्नत DRAM प्रक्रियाओं के साथ TSMC की 3nm लॉजिक प्रक्रिया शामिल है। लॉजिक और DRAM अलग-अलग काम करते हैं और इनके लिए अलग मैन्युफैक्चरिंग तरीके इस्तेमाल होते हैं। 3nm नाम लॉजिक मैन्युफैक्चरिंग की एक पीढ़ी बताता है, जबकि 1c DRAM तकनीक की एक पीढ़ी को दर्शाता है।
Samsung, SK hynix और Micron के अपने-अपने डिज़ाइन और उत्पादन विधियां हैं। जब कोई एक्सेलेरेटर डेवलपर एक से अधिक कंपनियों से मेमोरी खरीदना चाहता है, तो इन अंतरों के कारण अतिरिक्त परीक्षण करने पड़ सकते हैं। बेस डाई की एक साझा प्रक्रिया डेवलपरों को अधिक एकसमान शुरुआती आधार देती है।
वैलिडेशन का मतलब यह जांचना है कि प्रोसेसर, मेमोरी और पैकेज अपेक्षित गति, बिजली खपत और विश्वसनीयता के स्तर पर साथ काम करते हैं या नहीं। अलग-अलग कार्यान्वयनों के लिए यह काम दोहराने में इंजीनियरिंग का समय लगता है। Nvidia के प्रस्ताव का लक्ष्य मेमोरी आपूर्तिकर्ता बदलने पर अलग से किए जाने वाले इंटीग्रेशन कार्य को घटाना है।
Micron अपनी आगामी DRAM पीढ़ी को 1-gamma कहता है, जो व्यापक तौर पर Samsung और SK hynix की शब्दावली में इस्तेमाल होने वाली 1c पीढ़ी के समकक्ष है। इसलिए एक साझा लक्ष्य अलग-अलग कंपनियों के नाम वाली मैन्युफैक्चरिंग पीढ़ियों को साथ लाता है, न कि हर आपूर्तिकर्ता की मेमोरी प्रक्रिया को एकसमान बनाता है।
प्रतिस्पर्धी मेमोरी उत्पादों के लिए TSMC एक साझा मैन्युफैक्चरिंग साझेदार बन जाएगा। यह व्यवस्था अलग-अलग आपूर्तिकर्ताओं के उत्पादों पर Nvidia का काम आसान कर सकती है, लेकिन साथ ही उत्पादन के एक अहम चरण को एक फाउंड्री पर केंद्रित करती है। Samsung का वैकल्पिक मैन्युफैक्चरिंग रास्ते पर विचार करना पर्याप्त बेस डाई हासिल करने के व्यावहारिक महत्व को दिखाता है।
Samsung अपने कारखानों को भी विकल्प में रखेगा
Samsung मानक HBM के लिए अपना एकीकृत मैन्युफैक्चरिंग मॉडल बरकरार रखने की योजना बना रहा है। उसके HBM4 और HBM4E उत्पादों में बेस डाई के लिए Samsung की अपनी 4nm प्रक्रिया और कोर डाई के लिए 1c प्रक्रिया इस्तेमाल होती है। मेमोरी लेयर का निर्माण दक्षिण कोरिया में उसके ह्वासोंग और प्योंगटेक परिसरों में होता है।
Samsung ने 2026 की शुरुआत में HBM4 का बड़े पैमाने पर उत्पादन शुरू किया था, जबकि अक्टूबर की रिपोर्ट के समय HBM4E बड़े पैमाने पर उत्पादन के लिए क्वालिफिकेशन की प्रक्रिया में था। क्वालिफिकेशन वह परीक्षण चरण है, जिसमें यह तय किया जाता है कि कोई उत्पाद अपेक्षित मानक के अनुरूप लगातार बनाया जा सकता है या नहीं।
AMD समेत अन्य ग्राहकों के लिए कस्टम HBM में भी Samsung का एकीकृत तरीका बरकरार रहने की उम्मीद है। इसलिए NVHBM पर लिया गया फैसला Nvidia की ज़रूरतों तक सीमित है, न कि बेस डाई का उत्पादन कंपनी के भीतर करने से दूर जाने का कंपनीव्यापी कदम।
उम्मीद है कि Samsung का Memory Business, TSMC द्वारा बनाए जाने वाले बेस डाई के डिज़ाइन और ऑप्टिमाइज़ेशन में सहायता की अगुवाई करेगा। इससे Samsung के भीतर ज़िम्मेदारियों का बंटवारा बदलेगा, जहां System LSI और Foundry कारोबार पारंपरिक रूप से कंपनी के भीतर बने बेस डाई में योगदान देते रहे हैं।
Samsung यह भी आकलन कर रहा है कि अगर मांग TSMC की क्षमता से अधिक हो जाए तो क्या उसकी अपनी फाउंड्री NVHBM बेस डाई बना सकती है। यह प्रस्तावित बैकअप उत्पादन का एक और विकल्प बनाए रखेगा, हालांकि Nvidia का रिपोर्ट किया गया विनिर्देश फिलहाल TSMC की 3nm प्रक्रिया पर केंद्रित है।
Micron और SK hynix के अलग-अलग रास्ते
Micron का बदलाव Nvidia के कस्टम उत्पाद से आगे तक फैला है। कंपनी का कहना है कि Nvidia के साथ विकसित NVHBM और उसका मानक HBM4E, दोनों बाहरी फाउंड्री में बने बेस डाई इस्तेमाल करेंगे। उम्मीद है कि यह मैन्युफैक्चरिंग TSMC संभालेगा।
HBM4 के लिए Micron अपनी 1-beta प्रक्रिया से बने मेमोरी डाई को भीतर निर्मित बेस डाई के साथ जोड़ता है। HBM4E में मेमोरी लेयर 1-gamma पर जाती हैं और बेस डाई का उत्पादन Micron के कारखानों से बाहर चला जाता है। इसलिए Micron स्टैक के दोनों प्रमुख हिस्सों में बदलाव कर रहा है: नई मेमोरी प्रक्रिया अपनाते हुए बाहरी लॉजिक मैन्युफैक्चरिंग साझेदार का इस्तेमाल।
Micron के मुख्य परिचालन अधिकारी मनीष भाटिया को उम्मीद है कि NVHBM की औसत बिक्री कीमत अधिक और मार्जिन बेहतर होगा। उनका तर्क है कि HBM पहले से ही प्रीमियम कीमत पर बिकता है, जबकि कस्टमाइज़ेशन में शामिल अतिरिक्त काम और सुविधाएं अधिक मूल्य पैदा करती हैं। इसलिए बेस डाई का उत्पादन बाहर करवाना अधिक मुनाफे की उम्मीद के साथ मेल खा सकता है।
SK hynix पहले से ही HBM4 बेस डाई के लिए TSMC की 12nm लॉजिक प्रक्रिया इस्तेमाल करता है। उद्योग जगत की रिपोर्टों के मुताबिक, HBM4E और भविष्य के कस्टम HBM के लिए TSMC की 3nm प्रक्रिया को प्राथमिकता दी जा रही है। इससे अधिक उन्नत लॉजिक मैन्युफैक्चरिंग ऐसे घटक तक पहुंचेगी, जो अतिरिक्त ज़िम्मेदारियां संभाल रहा है।
SK hynix ने साल की शुरुआत में Nvidia के GTC कार्यक्रम में अपनी Stream DQ तकनीक पर आधारित कस्टम HBM अवधारणा भी दिखाई थी। यह अवधारणा प्रोसेसरों तक डेटा का लगातार प्रबंधन और प्रवाह सुनिश्चित करने पर केंद्रित है। तीनों आपूर्तिकर्ताओं में साझा रुझान यह है कि बेस डाई को डेटा के आवागमन में अधिक सक्रिय भूमिका दी जाए।
Nvidia के प्रदर्शन संबंधी आंकड़ों का अर्थ
Nvidia का कहना है कि NVHBM, मानक HBM4E की तुलना में प्रति स्टैक 30% तक अधिक बैंडविड्थ दे सकता है और HBM की बिजली खपत 15% घटा सकता है। बैंडविड्थ बताती है कि एक निश्चित समय में कितना डेटा भेजा जा सकता है। अधिक बैंडविड्थ उस AI प्रोसेसर की मदद कर सकती है जो मेमोरी से जानकारी मिलने की प्रतीक्षा कर रहा हो।
एक सरल तुलना में, अगर HBM4E का मानक स्टैक एक निश्चित अवधि में डेटा की 100 इकाइयां देता है, तो Nvidia के अधिकतम बताए गए सुधार से यह संख्या 130 हो जाएगी। अगर तुलना में इस्तेमाल होने वाली मेमोरी 100 इकाई बिजली खपत करती है, तो बताए गए कमी के अनुसार HBM की खपत 85 इकाई रह जाएगी। ये उदाहरण प्रतिशतों को समझाने के लिए हैं, किसी खास बाज़ार में उपलब्ध उत्पाद का विवरण नहीं।
Nvidia का यह भी कहना है कि XPU कंप्यूट डाई के क्षेत्रफल का 25% तक हिस्सा खाली हो सकता है। XPU कंप्यूटिंग प्रोसेसर के लिए व्यापक शब्द है, जिसमें कस्टम AI एक्सेलेरेटर भी शामिल हैं। मेमोरी सर्किटरी को दूसरी जगह ले जाने से डिज़ाइनरों को सिलिकॉन का अधिक हिस्सा कंप्यूटिंग कार्यों के लिए इस्तेमाल करने की जगह मिलती है।
Nvidia की प्रस्तुति की एक अन्य रिपोर्ट में मुख्य डाई पर 30% तक अधिक कंप्यूटिंग क्षमता का आंकड़ा दिया गया है। यह संभावित कंप्यूटिंग संसाधनों को मापता है, जबकि 25% का आंकड़ा आर्किटेक्चर में बदलाव से खाली हुए सिलिकॉन क्षेत्र को बताता है। डिज़ाइनरों को अब भी तय करना होगा कि इस खाली जगह का इस्तेमाल कैसे किया जाए।
बताया गया है कि कस्टम PHY इस इंटरफेस के इस्तेमाल वाले क्षेत्र को 67% तक घटा सकता है। एक तकनीकी आकलन पिनों की संख्या में कमी के आधार पर यह अनुमान लगाता है। Nvidia की बैंडविड्थ, बिजली खपत और क्षेत्रफल संबंधी व्यापक तुलनाओं में मानक HBM4E को आधार माना गया है, जबकि यह पीढ़ी अभी बाज़ार में आई भी नहीं थी।
AI सेवा में, अगर मेमोरी सीमित करने वाला कारक हो तो डेटा का तेज़ आवागमन जवाब जल्दी तैयार करने में मदद कर सकता है। मेमोरी की कम बिजली खपत से सिस्टम डिज़ाइनरों को बिजली बजट के भीतर अधिक गुंजाइश मिल सकती है। पूरे सर्वर पर असर प्रोसेसर, वर्कलोड, नेटवर्किंग और कूलिंग के साथ-साथ मेमोरी पर भी निर्भर करता है।
Amazon ने मेमोरी को Nvidia के व्यापक प्लेटफॉर्म से जोड़ा
Amazon की Annapurna Labs NVHBM की पहली घोषित साझेदार है। यह चिप डिज़ाइन कारोबार Amazon Web Services के लिए Trainium एक्सेलेरेटर विकसित करता है। इससे Nvidia को ऐसी कंपनी को मेमोरी तकनीक देने का रास्ता मिलता है जो अपने AI प्रोसेसर भी बनाती है।
Annapurna Labs के उपाध्यक्ष नाफ़िया भशारा ने घोषणा के साथ जारी टिप्पणी में साझेदारी का उद्देश्य बताया:
हम भविष्य के AWS इंफ्रास्ट्रक्चर डिज़ाइनों को लाभ पहुंचाने के लिए इस तकनीकी सहयोग को लेकर उत्साहित हैं।
उम्मीद है कि Annapurna का Trainium 4, NVLink Fusion को सपोर्ट करेगा। NVHBM की शुरुआत के बारे में आई रिपोर्टों में इसे या तो Trainium 4 के साथ या अगली पीढ़ी में पेश किए जाने की बात कही गई है; Amazon के NVHBM कार्यान्वयन की सटीक चिप पीढ़ी और व्यावसायिक उपलब्धता की तारीख सार्वजनिक रूप से तय नहीं हुई है।
NVLink Fusion पार्टनरों को NVLink Chiplet, NVLink-C2C, NVLink Switch और MGX सिस्टम तथा रैक जैसी तकनीकों तक पहुंच देता है। इनसे कस्टम प्रोसेसर को Nvidia के कंप्यूटिंग इंफ्रास्ट्रक्चर में शामिल करने के लिए कनेक्शन और सिस्टम डिज़ाइन मिलते हैं। NVHBM इस समूह में मेमोरी सबसिस्टम जोड़ता है।
रिपोर्टों के मुताबिक, NVHBM की घोषणा के पांच दिन बाद MediaTek ने NVLink Fusion अपनाया और इसे अपने XPU ग्राहकों के लिए उपलब्ध कराने की योजना बनाई। इससे Nvidia को कस्टम एक्सेलेरेटर परियोजनाओं में पहुंच का एक और रास्ता मिलता है, ऐसे बाज़ार में जहां Broadcom और Marvell भी प्रतिस्पर्धा करते हैं। Marvell ने दिसंबर 2024 में मेमोरी कंट्रोल को दूसरी जगह ले जाने का मिलता-जुलता तरीका बताया था। ऐसे में ग्राहकों का इसे अपनाना और सिस्टम में एकीकरण प्रतिस्पर्धा के अहम हिस्से हैं।
यह बदलाव कैसे सामने आया
NVHBM का विकास आर्किटेक्चर, आपूर्तिकर्ताओं के संबंधों और ग्राहकों द्वारा इसे अपनाने में आए बदलावों को साथ लाता है। घटनाक्रम से यह समझने में मदद मिलती है कि Samsung का अक्टूबर का फैसला क्यों अहम है: पहले Nvidia ने साझा डिज़ाइन पेश किया, फिर मेमोरी निर्माताओं को तय करना पड़ा कि वे इसका निर्माण कैसे करेंगे।
- दिसंबर 2024: Marvell ने मेमोरी कंट्रोल के कार्यों को अलग जगह रखने से जुड़ी एक मिलती-जुलती अवधारणा बताई।
- 2026 की शुरुआत में: Samsung ने HBM4 का बड़े पैमाने पर उत्पादन शुरू किया, जबकि SK hynix ने GTC में अपनी Stream DQ कस्टम HBM अवधारणा पेश की।
- 26 अगस्त, 2026: Nvidia ने NVLink Fusion में शामिल किए जाने वाले NVHBM की घोषणा की और Annapurna Labs को पहला साझेदार बताया।
- पांच दिन बाद: रिपोर्टों के मुताबिक, MediaTek ने NVLink Fusion अपनाया और इसे अपने XPU ग्राहकों के लिए उपलब्ध कराने की योजना बनाई।
- 18 अक्टूबर, 2026: उद्योग जगत की रिपोर्टों में TSMC के 3nm बेस डाई की Nvidia की मांग और आंतरिक समीक्षा के बाद Samsung की स्वीकृति का उल्लेख किया गया।
Samsung के फैसले से मेमोरी आपूर्तिकर्ताओं में एकसमान कार्यान्वयन के Nvidia के लक्ष्य के अनुरूप मैन्युफैक्चरिंग योजना आगे बढ़ती है। साथ ही, अपने बेस डाई में Samsung का लगातार निवेश मानक HBM और अन्य ग्राहकों को दिए जाने वाले कस्टम उत्पादों के लिए एक अलग रास्ता बनाए रखता है।
मुख्य बातें
- रिपोर्टों के मुताबिक, Nvidia चाहता है कि Samsung, SK hynix और Micron NVHBM बेस डाई के लिए TSMC की 3nm प्रक्रिया इस्तेमाल करें।
- NVHBM मेमोरी कंट्रोलर को मुख्य प्रोसेसर से हटाकर HBM स्टैक के बेस डाई में ले जाता है।
- Samsung ने अनुरोध स्वीकार कर लिया है, लेकिन मानक HBM और अन्य कस्टम उत्पादों के लिए आंतरिक मैन्युफैक्चरिंग जारी रखने की योजना है।
- Micron NVHBM और मानक HBM4E, दोनों के लिए बाहरी बेस डाई उत्पादन की योजना बना रहा है; SK hynix पहले से HBM4 के लिए TSMC के साथ काम करता है।
- Nvidia का दावा है कि मानक HBM4E की तुलना में बैंडविड्थ 30% तक बढ़ सकती है और HBM की बिजली खपत 15% घट सकती है।
- Amazon की Annapurna Labs पहली घोषित साझेदार है, जबकि Samsung अपने फाउंड्री को उत्पादन के संभावित बैकअप के रूप में परख रहा है।