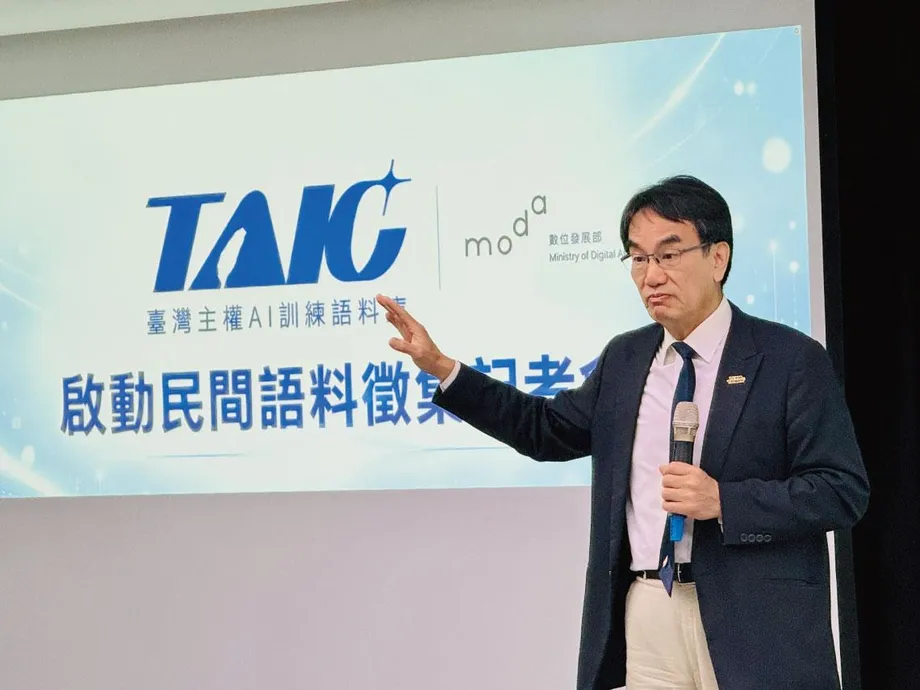
111 निजी योगदान ताइवान की एआई महत्वाकांक्षाओं में कमी उजागर करते हैं
ताइवान सरकार के एआई प्रशिक्षण संग्रह में 7,161 डेटा प्रविष्टियां हैं, लेकिन इनमें से केवल 111 निजी योगदानकर्ताओं से आई हैं। यह कुल का करीब 1.6% है। ताइवान की भाषा, संस्कृति और रोजमर्रा की जिंदगी को कृत्रिम बुद्धिमत्ता के लिए समझने योग्य बनाने के मकसद से शुरू की गई परियोजना में यह हिस्सा बहुत कम है।
विषय-सूची
- 111 निजी योगदान ताइवान की एआई महत्वाकांक्षाओं में कमी उजागर करते हैं
- सरकारी संग्रह में क्या है
- स्थानीय भाषा क्यों मायने रखती है
- आपराधिक शिकायत से बदला हिसाब
- एआई प्रशिक्षण में कॉपीराइट का सवाल
- स्वैच्छिक अनुमति, मालिकाना हक का हस्तांतरण नहीं
- भुगतान के साथ सहयोग की एक छोटी मिसाल
- कानूनी अपवाद और सामूहिक लाइसेंस, दो अलग विकल्प
- TAIDE दिखाता है कि सामग्री तक पहुंच और संसाधन, दोनों क्यों जरूरी हैं
- मुख्य बिंदु
डिजिटल मामलों के मंत्रालय ने 24 दिसंबर, 2025 को ताइवान सॉवरेन एआई ट्रेनिंग कॉर्पस शुरू किया। इसमें 200 से अधिक सरकारी एजेंसियों ने 600 मिलियन टोकन वाले 2,000 से ज्यादा डेटासेट का योगदान दिया। टोकन पाठ के छोटे हिस्से होते हैं जिन्हें एआई सिस्टम संसाधित करते हैं। ये कभी एक अक्षर होते हैं, तो कभी किसी शब्द का हिस्सा।
सरकारी भागीदारी से इस संग्रह का पैमाना बढ़ाने में मदद मिली है। प्रकाशकों, लेखकों, शिक्षण मंचों और समाचार संगठनों को शामिल करना अधिक कठिन है: डेवलपर्स को प्रशिक्षण के लिए मूल्यवान लेखन की प्रतियां बनाने की अनुमति चाहिए, जबकि सामग्री के मालिक चाहते हैं कि उन्हें भुगतान मिले और उनके काम के इस्तेमाल पर उनका नियंत्रण रहे।
14 अक्टूबर, 2026 को विधायी सुनवाई में डिजिटल मामलों के मंत्री लिन यी-जिंग ने कहा कि निजी क्षेत्र की भागीदारी स्वैच्छिक है और सरकार चाहती है कि बड़ी एआई कंपनियां, खासकर अमेरिकी कंपनियां, प्रशिक्षण सामग्री के लिए भुगतान करें। मौजूदा निजी संग्रह कार्यक्रम में समाचार सामग्री शामिल नहीं है।
इसका व्यावहारिक महत्व किसी डेटाबेस के आकार से कहीं आगे तक जाता है। ताइवानी लेखन पर प्रशिक्षित मॉडल स्थानीय शब्दावली सीख सकता है, सांस्कृतिक परंपराएं समझा सकता है और ताइवान की संस्थाओं को ध्यान में रखकर सवालों के जवाब दे सकता है। लेकिन यह सामग्री बनाने वाले लेखक और संगठन भी इसके व्यावसायिक मूल्य पर निर्भर हैं। ताइवान उनके काम तक पहुंच बढ़ाने के साथ-साथ यह तय करने की कोशिश कर रहा है कि भुगतान कौन करे, अनुमति में क्या-क्या शामिल हो और कॉपीराइट नियमों में कहां स्पष्टीकरण की जरूरत है।
सरकारी संग्रह में क्या है
मंत्रालय की दिसंबर में जारी शुरुआत की घोषणा के अनुसार, इस संग्रह में भाषा, संस्कृति, शिक्षा, जीवविज्ञान और भूगोल से जुड़ी सामग्री है। यह दस साल से अधिक समय के सरकारी ओपन डेटा पर आधारित है और उपयोगकर्ताओं को सामग्री खोजने तथा डाउनलोड करने की सुविधा देता है।
संस्कृति मंत्रालय ने सार्वजनिक कला और सांस्कृतिक संपदाओं से जुड़े डेटासेट दिए। शिक्षा मंत्रालय ने ताइवानी, हक्का और मंदारिन भाषाओं के शब्दकोश संबंधी डेटा का योगदान किया। इन संसाधनों से डेवलपर्स को स्थानीय अर्थों और इस्तेमाल के साथ-साथ स्थानों, वस्तुओं और परंपराओं के बारे में सामग्री मिलती है।
मंत्रालय के कॉर्पस कार्यक्रम के विवरण में भाग लेने वाली एजेंसियों में स्वदेशी जनजातियों की परिषद और हक्का मामलों की परिषद का भी नाम है। प्रस्तावित विषयों में इतिहास, सांस्कृतिक विरासत, पर्यटन और स्थानीय संस्कृति शामिल हैं। मंत्रालय का कहना है कि उपयोगी प्रशिक्षण पाठ सुसंगत, पूर्ण और प्रवाहपूर्ण होना चाहिए।
सितंबर 2026 में विधायकों के सामने पेश किए गए आंकड़ों के मुताबिक, संग्रह में 5,000 से अधिक डेटासेट और 2.4 अरब से ज्यादा टोकन थे। शुरुआत के समय घोषित 600 मिलियन टोकन की तुलना में, टोकन के हिसाब से यह पाठ की मात्रा चार गुने से भी ज्यादा है। 7,161 प्रविष्टियां और 111 निजी योगदान संग्रह की संरचना की एक और झलक देते हैं।
स्थानीय भाषा क्यों मायने रखती है
सामुदायिक ज्ञान परियोजना Taiwan.md के संस्थापक और नए मीडिया कलाकार वू चे-यू का कहना है कि मुख्यधारा के एआई प्रशिक्षण में पारंपरिक चीनी लेखन को बहुत कम जगह मिलती है। अपने प्रोजेक्ट की जरूरत समझाते हुए वे चीनी भाषा की प्रशिक्षण सामग्री में इसकी हिस्सेदारी 1% से कम बताते हैं।
वू की चिंता केवल सरल चीनी अक्षरों को पारंपरिक अक्षरों में बदलने तक सीमित नहीं है। ताइवान और चीन में रोजमर्रा की कुछ चीजों के लिए अलग-अलग शब्द इस्तेमाल होते हैं और एक ही अभिव्यक्ति के अर्थ भी अलग हो सकते हैं। स्थानीय ज्ञान में संस्थाएं, इतिहास और खानपान भी शामिल हैं, जैसे ऐसे व्यंजन जिन्हें बबल टी या सूप डंपलिंग्स जितना अंतरराष्ट्रीय ध्यान नहीं मिलता।
Taiwan.md एआई टूल्स का उपयोग वेब से जानकारी जुटाने और ताइवान की प्रकृति, समाज और इतिहास पर लेख संपादित करने के लिए करता है। इसके 1,123 लेख सार्वजनिक रूप से उपलब्ध अकादमिक शोधपत्रों, ब्लॉगों और सरकारी जानकारी पर आधारित हैं। वू चाहते हैं कि ChatGPT, Gemini और Claude जैसे मुख्यधारा के मॉडल को ताइवानी अनुभव दर्शाने वाला अधिक लेखन उपलब्ध हो।
सरकार अपनी इससे जुड़ी महत्वाकांक्षा को सॉवरेन एआई कहती है: ऐसे एआई संसाधन और क्षमताएं विकसित करना जिन्हें ताइवान अपनी जरूरतों के अनुसार ढाल सके। इसका कॉर्पस प्रशिक्षण सामग्री देता है, जबकि Taiwan.md जैसी परियोजनाएं स्थानीय ज्ञान को एआई डेवलपर्स के लिए अधिक सुलभ बनाने की कोशिश करती हैं।
आपराधिक शिकायत से बदला हिसाब
जुलाई 2025 में नेशनल ताइवान यूनिवर्सिटी के एक डॉक्टरेट छात्र के खिलाफ कॉपीराइट उल्लंघन की आपराधिक शिकायत दर्ज हुई। छात्र ने 140,000 अनधिकृत सेंट्रल न्यूज एजेंसी लेखों वाला पारंपरिक चीनी भाषा का कॉर्पस साझा किया था। छात्र ने यह सामग्री एक ऐसी अमेरिकी वेबसाइट से जुटाई थी जहां खुले संसाधन उपलब्ध थे और इसे बिना शुल्क लिए साझा किया था।
बाद में दोनों पक्षों के बीच समझौता हो गया। छात्र ने माफी मांगी, शोधकर्ताओं से अपने डेटा स्रोतों की वैधता जांचने का आग्रह किया और पूरा कॉर्पस हटा दिया।
वू का कहना है कि इस मामले से स्वतंत्र डेवलपर्स अधिक सतर्क हो गए हैं। संभावित कॉपीराइट समस्या दिखने पर उनकी Taiwan.md टीम सामग्री हटा देती है, जिससे संग्रह का विस्तार धीमा पड़ता है। छोटी परियोजना के लिए, अनुमति की जांच के पहले से कठिन काम के साथ आपराधिक कार्रवाई का जोखिम भी निजी खतरा जोड़ता है।
मामले के विकास को समझने में कुछ तारीखें मदद करती हैं:
- 2023 की शुरुआत: राष्ट्रीय विज्ञान और प्रौद्योगिकी परिषद ने 200 मिलियन ताइवानी डॉलर से अधिक की निधि के साथ TAIDE भाषा मॉडल परियोजना शुरू की।
- जुलाई 2025: डॉक्टरेट छात्र को अनधिकृत समाचार लेखों वाले कॉर्पस के मामले में शिकायत का सामना करना पड़ा।
- 24 दिसंबर, 2025: डिजिटल मामलों के मंत्रालय ने 600 मिलियन टोकन वाले अपने सॉवरेन एआई कॉर्पस की घोषणा की।
- सितंबर 2026: मंत्रालय के आंकड़ों में 5,000 से अधिक डेटासेट और 2.4 अरब से ज्यादा टोकन दिखाए गए।
- 14 अक्टूबर, 2026: मंत्री लिन ने विधायकों से कहा कि निजी योगदान स्वैच्छिक हैं और भुगतान वाले सामग्री समझौते नीति का लक्ष्य हैं।
एआई प्रशिक्षण में कॉपीराइट का सवाल
लुगुओ लॉ फर्म के वरिष्ठ वकील चेन ची-तुंग प्रतिलिपि बनाने को एक प्रमुख कानूनी मुद्दा बताते हैं। किसी मॉडल को प्रशिक्षित करने से पहले डेवलपर्स को आम तौर पर पाठ की प्रतियां बनानी पड़ती हैं। कॉपीराइट कानून अधिकारधारकों को अपनी रचनाओं की प्रतियां बनाने पर नियंत्रण देता है, हालांकि उचित उपयोग जैसे अपवाद भी हैं।
कुछ विशेष परिस्थितियों में उचित उपयोग संरक्षित रचना को बिना अनुमति इस्तेमाल करने की छूट देता है। चेन का कहना है कि ताइवान के मौजूदा प्रावधानों में एआई प्रशिक्षण का स्पष्ट उल्लेख नहीं है। इस कारण डेवलपर्स को पता नहीं कि अदालत उनके इस्तेमाल को स्वीकार करेगी या नहीं।
प्रशिक्षण और जवाब तैयार करना भी अलग-अलग प्रक्रियाएं हैं। प्रशिक्षण के दौरान सिस्टम उदाहरणों को संसाधित करके पैटर्न सीखता है। जवाब बनाते समय वह उपयोगकर्ता के लिए पाठ तैयार करता है। चेन का प्रस्ताव है कि कानून इन दोनों चरणों को अलग-अलग देखे और ऐसे आउटपुट के जोखिम को भी संबोधित करे जो संरक्षित रचनाओं से काफी मिलते-जुलते हों।
आर्थिक मामलों के मंत्रालय के अधीन बौद्धिक संपदा कार्यालय का कहना है कि संभावित कानूनी बदलावों पर अभी अध्ययन चल रहा है। डिजिटल मामलों का मंत्रालय इसी कार्यालय को कॉपीराइट नीति के लिए जिम्मेदार बताता है। कंट्रोल युआन की एक जांच में भी, कार्यकारी युआन द्वारा जिम्मेदारी कार्यालय को सौंपे जाने के बाद कानूनी ढांचे को बदलने के लिए सक्रिय काम करने की सिफारिश की गई।
स्वैच्छिक अनुमति, मालिकाना हक का हस्तांतरण नहीं
मंत्री लिन ने विधायिका की परिवहन समिति को बताया कि निजी संग्रह कार्यक्रम की शुरुआत प्रकाशकों और ई-पुस्तक मंचों से होगी। उन्होंने सामग्री की चार श्रेणियां बताईं जिनकी तलाश की जा रही है:
- ऐसी किताबें जिनका कॉपीराइट संरक्षण समाप्त हो चुका है।
- प्रकाशकों द्वारा उपलब्ध कराए गए किताबों के विवरण।
- किताबों से चुने गए पूर्वावलोकन अंश।
- व्यक्तिगत लेखकों की स्वैच्छिक लाइसेंस वाली रचनाएं।
लिन ने कहा कि मंत्रालय एआई प्रशिक्षण के लिए रचनाओं के इस्तेमाल की अनुमति मांग रहा है और कॉपीराइट का मालिकाना हक लेखकों के पास ही रहेगा। लाइसेंस दूसरे पक्ष को सहमत शर्तों के तहत तय गतिविधियां करने की अनुमति देता है। इसमें इस्तेमाल के स्वीकृत तरीके और अवधि जैसी बातें शामिल हो सकती हैं।
डेमोक्रेटिक प्रोग्रेसिव पार्टी की विधायक लिन चु-यिन ने सवाल उठाया कि योगदानकर्ताओं को भुगतान कैसे मिलेगा, बाद में अनुमति वापस लेने पर क्या होगा और प्रशिक्षण से दूसरे उत्पाद बनने पर उनके हितों की रक्षा कैसे की जाएगी। ताइवान पीपुल्स पार्टी के विधायक हंग यू-शियांग ने गुणवत्ता जांच, अधिकारों की मंजूरी, भुगतान करके सामग्री हासिल करने और अलग-अलग लाइसेंस श्रेणियों के प्रबंधन वाली सेवा का प्रस्ताव रखा।
मंत्रालय ने ताइवान सॉवरेन एआई ट्रेनिंग कॉर्पस लाइसेंस, संस्करण 1 प्रकाशित किया है और एजेंसियों को इसे लागू करने में मदद देने के लिए बौद्धिक संपदा कार्यालय के साथ उदाहरण तैयार किए हैं। मानक शर्तों का मकसद बार-बार बातचीत और कॉपीराइट विवाद कम करना है। मंत्रालय योगदान के लिए प्रोत्साहन की योजना भी बना रहा है। सार्वजनिक रूप से बताए गए प्रस्तावों में भुगतान की दरें, अनुमति वापस लेने की व्यवस्था और उससे बने उत्पादों के नियम अभी तय नहीं हैं।
भुगतान के साथ सहयोग की एक छोटी मिसाल
ओपन कल्चर फाउंडेशन के अध्यक्ष ली पो-फेंग का कहना है कि प्रकाशकों से मूल्यवान सामग्री मुफ्त में देने को कहने से पर्याप्त भागीदारी मिलने की संभावना कम है। वे एक छोटी प्रशिक्षण परियोजना का उदाहरण देते हैं, जिसने बातचीत के जरिए मीडिया और शिक्षा मंचों का सहयोग हासिल किया।
समझौते में एकमुश्त लाइसेंस भुगतान, डेटा के इस्तेमाल पर दो साल की सीमा और भाग लेने वाले सामग्री प्रदाताओं को तैयार मॉडल तक प्राथमिक पहुंच शामिल थी। इस व्यवस्था में योगदानकर्ताओं को पैसा, उपयोग की तय अवधि और बदले में कुछ उपयोगी मिला।
युआन-लिउ पब्लिशिंग के अध्यक्ष वांग रोंग-वेन भी कहते हैं कि सरकारी और वाणिज्यिक डेवलपर्स को सामग्री लाइसेंस के लिए बजट रखना चाहिए। उनके अनुसार, आपराधिक शिकायतों का डर निजी डेवलपर्स और एआई परियोजनाओं को समर्थन देने की कोशिश कर रहे अधिकारियों, दोनों के लिए बाधा है।
लिन ने विधायकों से कहा कि बड़ी एआई कंपनियों को भुगतान लेकर सामग्री तक पहुंच देना सरकार का अंतिम लक्ष्य है। उन्होंने कहा कि नई तकनीक से जुड़े कॉपीराइट विवाद तीन से पांच साल तक चल सकते हैं, इसलिए मंत्रालय कम विवाद वाली सामग्री से शुरुआत कर रहा है। उनकी समयसीमा विवाद की संभावित अवधि बताती थी, न कि कानून या भुगतान योजना की समयसीमा।
कानूनी अपवाद और सामूहिक लाइसेंस, दो अलग विकल्प
चेन ताइवान के कॉपीराइट कानून में एआई पर एक अलग अध्याय जोड़ने का प्रस्ताव रखते हैं। इसमें टेक्स्ट और डेटा माइनिंग के लिए अपवाद स्थापित किया जाएगा, प्रशिक्षण स्रोतों का खुलासा अनिवार्य होगा और शर्तें पूरी करने वाली गतिविधियों के लिए आपराधिक कार्रवाई का जोखिम कम किया जाएगा।
टेक्स्ट और डेटा माइनिंग का मतलब है सॉफ्टवेयर की मदद से बड़ी मात्रा में सामग्री का विश्लेषण कर पैटर्न पहचानना। यूरोपीय संघ, जापान और सिंगापुर में इस गतिविधि के कुछ रूपों के लिए अपवाद हैं, हालांकि उनके नियम और शर्तें अलग-अलग हैं। चेन इन्हें ताइवान में चर्चा के लिए मिसाल मानते हैं।
ली इससे पहले उठाए जा सकने वाले एक प्रशासनिक कदम का प्रस्ताव देते हैं: ऐसे दिशानिर्देश जो बताएं कि अधिकारी प्रशिक्षण के किन इस्तेमालों को उचित उपयोग मानते हैं और किनसे उल्लंघन का जोखिम पैदा होता है। वे जापान की सांस्कृतिक मामलों की एजेंसी और उसकी 2024 की एआई कॉपीराइट चेकलिस्ट तथा मार्गदर्शिका का उदाहरण देते हैं, जिसने डेवलपर्स और रचनाकारों के लिए अपेक्षाओं को अधिक व्यावहारिक बनाया।
चेन सामूहिक लाइसेंसिंग का सुझाव भी देते हैं और संगीत क्षेत्र की म्यूजिक कॉपीराइट सोसाइटी ऑफ चाइनीज ताइपे, जिसे MÜST कहा जाता है, का उदाहरण देते हैं। इस मॉडल में एक संगठन कई अधिकारधारकों की ओर से अनुमतियों का प्रबंधन करता है, शुल्क वसूलता है और भुगतान बांटता है। एआई के लिए ऐसी ही सेवा से सैकड़ों प्रकाशकों या लेखकों के साथ अलग-अलग बातचीत की जरूरत कम हो सकती है।
नेशनल ताइपेई यूनिवर्सिटी ऑफ टेक्नोलॉजी के बौद्धिक संपदा संस्थान के सहायक प्रोफेसर चांग चुंग-ह्सिन की राय इससे अलग है। उनका तर्क है कि डेवलपर्स को कानून बदलने की मांग करने के बजाय मौजूदा कॉपीराइट नियमों के तहत भुगतान करना चाहिए। उनके विचार में समाधान का केंद्र प्रकाशन और समाचार सामग्री तक बातचीत के जरिए पहुंच बनाना है।
TAIDE दिखाता है कि सामग्री तक पहुंच और संसाधन, दोनों क्यों जरूरी हैं
ताइवान का पहले का ट्रस्टवर्दी एआई डायलॉग इंजन, यानी TAIDE, दिखाता है कि कोई मॉडल कुछ आसानी से उपलब्ध संग्रहों पर कितना निर्भर हो सकता है। 2023 की शुरुआत में राष्ट्रीय विज्ञान और प्रौद्योगिकी परिषद की परियोजना के रूप में स्थापित इसके शुरुआती विकास के लिए 200 मिलियन ताइवानी डॉलर से अधिक की निधि मिली।
TAIDE ने 15 सरकारी एजेंसियों से प्रशिक्षण सामग्री ली। सेंट्रल न्यूज एजेंसी के करीब 40 लाख लेख इसके पाठ्य डेटा का 70% थे। कॉपीराइट संबंधी चिंताओं को ध्यान में रखकर यह सामग्री जुटाई गई थी। इससे पता चलता है कि बड़े समाचार अभिलेखों तक व्यवस्थित पहुंच स्थानीय मॉडल को सहारा दे सकती है।
एकेडेमिया सीनिका के ताइवान इन्फॉर्मेशन सिक्योरिटी सेंटर के प्रमुख शोधकर्ता युह-जे ली ने घरेलू विकल्प होने का महत्व समझाया:
शुरुआत में शायद हम बड़े इंजनों की बराबरी न कर पाएं, लेकिन अपना संवाद इंजन होने का मतलब है कि हमारे पास कम से कम एक विकल्प है।
शुरुआती मॉडल Meta के Llama 2 पर बनाया गया था और इसमें सात अरब पैरामीटर थे। ये वे संख्यात्मक सेटिंग्स हैं जिन्हें मॉडल सीखते समय समायोजित करता है। नेशनल सेंटर फॉर हाई-परफॉर्मेंस कंप्यूटिंग के पास 1,028 V100 ग्राफिक्स प्रोसेसर थे। केंद्र ने अपनी नियमित सेवाएं जारी रखते हुए, नवंबर 2023 में परियोजना के लिए नौ H100 प्रोसेसर खरीदे।
नेशनल चुंग हसिंग यूनिवर्सिटी की कृषि संबंधी सवालों के जवाब देने वाली परियोजना Demeter GPT ने बाद में ChatGPT से TAIDE का इस्तेमाल शुरू किया। एसोसिएट प्रोफेसर फैन याओ-चुंग ने अतिरिक्त प्रशिक्षण के बाद चीनी भाषा में बेहतर सटीकता का जिक्र किया। उनकी प्रयोगशाला पहले OpenAI को हर जवाब के लिए 1 से 2 ताइवानी डॉलर देती थी। TAIDE स्थानीय स्तर पर चलाने से परिचालन खर्च उनके अपने कंप्यूटर और बिजली तक सीमित हो गया।
ताइवान की कॉर्पस पहल ऐसे अनुप्रयोगों के पीछे की पाठ्य सामग्री की आपूर्ति को संबोधित करती है। सरकारी शब्दकोश और सांस्कृतिक अभिलेख एक आधार देते हैं। प्रकाशन सामग्री, विशेषज्ञ शिक्षण सामग्री और पत्रकारिता तक व्यापक पहुंच ऐसे समझौतों पर निर्भर करेगी जिन्हें डेवलपर्स वहन कर सकें और सामग्री के मालिक स्वीकार करने को तैयार हों।
मुख्य बिंदु
- निजी योगदानकर्ताओं ने कॉर्पस की 7,161 प्रविष्टियों में से 111 का योगदान किया, यानी करीब 1.6%।
- सरकार ने दिसंबर 2025 में शुरुआत के समय 600 मिलियन टोकन की घोषणा की थी; सितंबर 2026 तक कुल संख्या 2.4 अरब से अधिक हो गई।
- मंत्री लिन का कहना है कि निजी भागीदारी स्वैच्छिक है और कॉपीराइट का मालिकाना हक लेखकों के पास रहता है।
- मौजूदा निजी संग्रह कार्यक्रम में समाचार सामग्री शामिल नहीं है, जबकि मंत्रालय एआई कंपनियों के साथ भुगतान वाले समझौते चाहता है।
- जुलाई 2025 में 140,000 अनधिकृत समाचार लेखों को लेकर दर्ज आपराधिक शिकायत से स्वतंत्र डेवलपर्स की चिंता बढ़ी।
- प्रस्तावों में उचित उपयोग पर स्पष्ट दिशानिर्देश, डेटा माइनिंग का अपवाद, सामूहिक लाइसेंसिंग और मौजूदा कानून के तहत सीधे भुगतान शामिल हैं।