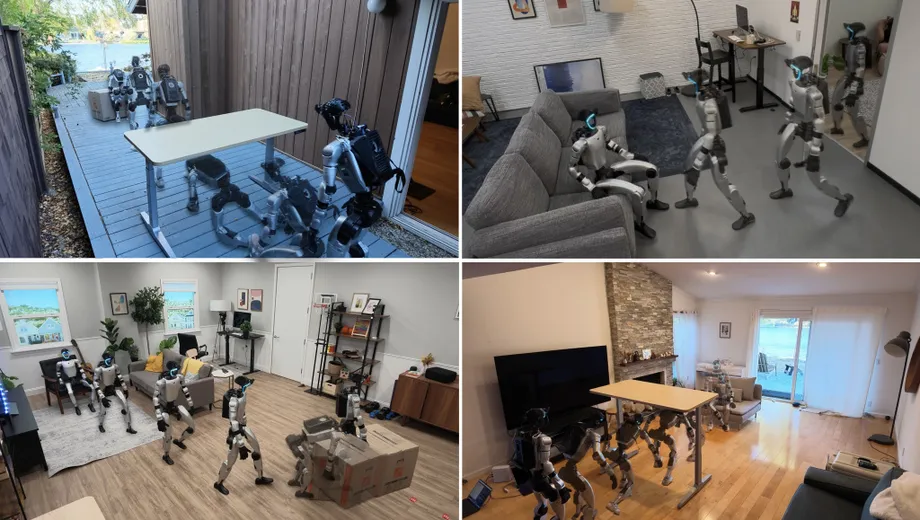
वर्चुअल घरों में प्रशिक्षित रोबोट ने असली कमरों में काम किया
ऐपल के शोधकर्ताओं का कहना है कि उनका HALO ह्यूमनॉइड कंट्रोल सिस्टम छह ऐसे वास्तविक परिवेशों में 360 परीक्षणों के दौरान अलग-अलग शारीरिक कार्यों में औसतन 91% सफल रहा, जिन्हें उसके लिए पहले कभी स्कैन या मैप नहीं किया गया था। यूनिट्री रोबोटिक्स के G1 पर चलने वाले इस सिस्टम ने सिमुलेशन से सीखी बातों का इस्तेमाल अपरिचित जगहों में चलने, फर्नीचर पर बैठने, संकरे रास्तों से गुजरने और डिब्बों को धकेलने में किया।
विषय-सूची
- वर्चुअल घरों में प्रशिक्षित रोबोट ने असली कमरों में काम किया
- 91% के नतीजे में क्या शामिल है
- लंबे निर्देश अधिक कठिन क्यों हैं
- तीन स्तर अनुरोध को गति में बदलते हैं
- G1 पर लगा Mac mini
- 1,000 वर्चुअल घरों से प्रशिक्षण के उदाहरण
- कंप्यूटिंग का खर्च और मानवीय काम
- दृष्टि से संपर्क की समस्या पूरी तरह हल नहीं होती
- यह शोध क्या बदलता है
- मुख्य बिंदु
ये नतीजे 4 नवंबर, 2026 को arXiv पर प्रस्तुत शोधपत्र Perceptive Humanoid Motion from Simulation में प्रकाशित हुए। ऐपल टीम के शोधपत्र में बताया गया है कि सिस्टम को कंप्यूटर से बनाए गए 1,000 घरेलू परिवेशों में लगभग 300 घंटे के कृत्रिम उदाहरणों से प्रशिक्षित किया गया और फिर सीधे एक भौतिक रोबोट पर इस्तेमाल किया गया।
लंबे कार्य अधिक कठिन साबित हुए। एक अलग वास्तविक परिवेश में, तीन क्रियाओं के संयोजनों में HALO की औसत सफलता दर 70% रही। हर संयोजन को 10 बार आजमाया गया। बाधा के नीचे झुककर निकलने, लक्ष्य के पास पहुंचने और एक डिब्बे को धकेलने वाले क्रम में 10 में से पांच प्रयास सफल रहे।
इसका व्यावहारिक महत्व यह है कि किसी अनुरोध को समझने और पूरे शरीर को अपरिचित फर्नीचर के बीच ले जाने की प्रक्रिया को जोड़ा गया है। कुर्सी पर बैठने जैसे निर्देश के लिए रोबोट को सीट पहचाननी होती है, रास्ता ढूंढना होता है, शरीर को सही जगह रखना होता है और नीचे बैठते समय संतुलन बनाए रखना होता है। HALO इन जिम्मेदारियों को तीन सहयोगी नियंत्रण स्तरों में बांटता है।
लेखक सियुआन हू, अबुलिकेमु अबुदुवेइली, यू मेंग, शिपेंग लियू, क्वेंटिन लेबुते, चेन चेन, मैथियास म्यूलर और व्लादलेन कोल्टुन हैं। सभी के साथ ऐपल का संबद्धता-उल्लेख दिया गया है। उन्होंने डेटा निर्माण, प्रशिक्षण और तैनाती से जुड़ा कोड भी जारी किया है, जिसमें सिमुलेशन और भौतिक रोबोटों पर कार्य-योजना, गति निर्माण और गति ट्रैकिंग शामिल हैं।
91% के नतीजे में क्या शामिल है
छह अलग-अलग कौशलों की सफलता दर अलग-अलग रही। झुककर बैठने में प्रदर्शन सबसे अच्छा था, जबकि परखी गई क्रियाओं में बैठना सबसे कम सफल रहा:
- नाम लेकर बताए गए वस्तु तक जाना: 92%।
- फर्नीचर पर बैठना: 85%।
- आधे खुले दरवाजे से गुजरना: 93%।
- बाधा के नीचे झुकना: 100%।
- बाधा के नीचे से रेंगकर निकलना: 90%।
- डिब्बे को धकेलना: 88%।
झुकने और बैठने के प्रदर्शन में 15 प्रतिशत अंक का अंतर था। बैठने के लिए सही जगह तक पहुंचना भर काफी नहीं है: रोबोट को फर्नीचर के साथ अपनी स्थिति ठीक करनी होती है और अपना वजन सीट पर डालना होता है। इसके लिए उसकी दृश्य समझ और भौतिक नियंत्रक, दोनों को काम करना पड़ता है।
HALO के लिए मूल्यांकन के सभी छह परिवेश अपरिचित थे। शोधकर्ताओं ने उन्हें पहले स्कैन नहीं किया था और न ही प्रशिक्षण के दौरान इस्तेमाल किया था। शोधपत्र इसे जीरो-शॉट ट्रांसफर कहता है: यानी सिस्टम को हर नई जगह के लिए अतिरिक्त प्रशिक्षण दिए बिना सिमुलेशन में प्रशिक्षित किया गया और फिर उन वास्तविक परिवेशों में इस्तेमाल किया गया।
प्रदर्शनों में G1 को किसी व्यक्ति के पीछे चलते, सोफे पर बैठते, आधे खुले दरवाजे से बगल की ओर गुजरते और मेज के नीचे झुककर या रेंगकर निकलते भी दिखाया गया है। ये गतिविधियां बताती हैं कि सिस्टम सिर्फ किसी गंतव्य की ओर चलने के बजाय आसपास की जगह के हिसाब से अपनी मुद्रा बदलता है।
लंबे निर्देश अधिक कठिन क्यों हैं
HALO के तीन कार्य-संयोजनों में नतीजे अलग-अलग रहे। दरवाजे से गुजरकर लक्ष्य तक पहुंचने का क्रम सभी 10 परीक्षणों में सफल रहा। झुककर बैठने का क्रम छह बार सफल हुआ। झुकने, लक्ष्य के पास पहुंचने और डिब्बा धकेलने का क्रम पांच बार सफल हुआ।
कुल मिलाकर, 30 प्रयासों में 21 क्रम सफल रहे, यानी सफलता दर 70% रही। यह अलग-अलग कार्यों के औसत से 21 प्रतिशत अंक कम है, हालांकि इन क्रमों का परीक्षण अलग परिवेश में और कम परीक्षणों के साथ किया गया।
एक क्रम में परेशानी की गुंजाइश बढ़ जाती है, क्योंकि एक गतिविधि के बाद रोबोट जिस स्थिति में पहुंचता है, वही अगली गतिविधि की शुरुआती स्थिति बनती है। उदाहरण के लिए, बाधा के नीचे से निकलने के बाद रोबोट को ऐसी स्थिति में होना चाहिए कि वह लक्ष्य तक पहुंच सके और अगली गतिविधि कर सके।
HALO दृश्य जांच के जरिए इस समस्या से निपटता है। उसका योजनाकार रोबोट के नजरिए से वीडियो देखता है, आकलन करता है कि मौजूदा गतिविधि सफल हुई या नहीं और तय करता है कि आगे बढ़ना है या दोबारा प्रयास करना है। नतीजे दिखाते हैं कि उपयोगी कौशलों को जोड़ना, उन्हें अलग-अलग करने से अधिक चुनौतीपूर्ण है।
तीन स्तर अनुरोध को गति में बदलते हैं
सबसे ऊपरी नियंत्रण स्तर कार्य-योजना संभालता है। यह अनुरोध को कैमरे के दृश्य के साथ समझने के लिए विजन-लैंग्वेज मॉडल का इस्तेमाल करता है, जो तस्वीरों और शब्दों, दोनों को संसाधित करने वाली AI की एक किस्म है। डिफॉल्ट मॉडल Qwen3.6-35B-A3B है, जो रोबोट के साथ लगे Mac mini पर स्थानीय रूप से चलता है।
योजनाकार हर दो सेकंड में सक्रिय होता है। अगर कोई रोबोट से बिना सीट बताए बैठने को कहता है, तो उसे दृश्य में मौजूद उपयुक्त वस्तु चुननी होती है। अगर कुर्सी तक जाने का रास्ता मेज से रुकता है, तो वह निर्देश को छोटी गतिविधियों में बांट सकता है: रुकावट के नीचे झुककर निकलना, कुर्सी तक जाना और बैठना।
बीच का स्तर हर उपकार्य को गति-योजना में बदलता है। इसमें Qwen3.5-2B, जिसके एनकोडर पैरामीटर प्रशिक्षण के दौरान स्थिर रहते हैं, और एक डिफ्यूजन ट्रांसफॉर्मर डिकोडर शामिल हैं, जो पूरे शरीर की गति तैयार करता है। एनकोडर तस्वीर और निर्देश को ऐसे निरूपण में बदलता है, जिसका इस्तेमाल गति मॉडल कर सके; डिकोडर नियोजित मुद्राएं तैयार करता है।
यह स्तर लगभग पांच सेकंड आगे की गतिविधि देखता है और प्रति सेकंड करीब तीन बार नई योजना बनाता है। इस तरह वह आसपास के नए कैमरा दृश्यों के आधार पर अपनी इच्छित गति को लगातार अपडेट करता रहता है, न कि आसपास की जांच किए बिना पूरे पांच सेकंड की गतिविधि तय कर देता है।
सबसे निचले स्तर को मोशन ट्रैकर कहा जाता है। यह योजनाओं को प्रति सेकंड 50 बार जोड़-संबंधी आदेशों में बदलता है। इसमें गहराई वाली तस्वीरों के साथ रोबोट की अपनी स्थिति और गति की जानकारी जोड़ी जाती है, जिससे उसे संतुलन, संपर्क और मोटरों की सीमाओं का ध्यान रखते हुए योजना पर चलने में मदद मिलती है।
G1 पर लगा Mac mini
भौतिक व्यवस्था में M4 Pro चिप और 64 GB यूनिफाइड मेमोरी वाला Mac mini, G1 की पीठ पर लगे एक सुरक्षात्मक खोल में रखा गया है। यह कंप्यूटर अधिक जटिल कार्य-योजना और गति-निर्माण मॉडल चलाता है। G1 का अपना ऑनबोर्ड प्रोसेसर मोशन ट्रैकर चलाता है।
कस्टम हेड माउंट पर OAK-1W कैमरा लगा है। इसका रंगीन वीडियो 1280 गुणा 800 पिक्सल के रिजॉल्यूशन पर प्रति सेकंड 30 फ्रेम की दर से चलता है और 120 डिग्री का दृश्य क्षेत्र कवर करता है। चौड़ा दृश्य शरीर के चलते समय सिस्टम को आसपास के फर्नीचर और रास्तों पर नजर रखने में मदद करता है।
रोबोट बिना केबल से जुड़े चलता है और उसके सॉफ्टवेयर घटक ZeroMQ नामक संदेश-प्रणाली के जरिए संवाद करते हैं। इसका डिफॉल्ट स्थानीय सेटअप इंटरनेट कनेक्शन के बिना काम कर सकता है। कॉन्फिगर करने पर HALO एप्लिकेशन प्रोग्रामिंग इंटरफेस के जरिए क्लाउड मॉडल का भी इस्तेमाल कर सकता है।
कंप्यूटिंग के काम का यह बंटवारा नियंत्रण के पदानुक्रम के अनुरूप है। किसी अनुरोध को समझने का काम कम बार हो सकता है, जबकि चलते रोबोट को स्थिर रखने के लिए कहीं तेज अपडेट जरूरी हैं। मोशन जनरेटर नई योजना तैयार करता है, जबकि ट्रैकर मौजूदा योजना को लागू करता रहता है। इससे मॉडल की गणना के दौरान हर बार रोबोट को रोकना नहीं पड़ता।
1,000 वर्चुअल घरों से प्रशिक्षण के उदाहरण
HALO की प्रशिक्षण प्रक्रिया एक खास कमी को दूर करने की कोशिश करती है: ऐसे उदाहरणों की कमी, जो ह्यूमनॉइड के देखे हुए दृश्य, उसे दिए गए निर्देश और पूरे शरीर की गति को जोड़ते हों। सामान्य वीडियो में गतिविधियों की तस्वीरें होती हैं, लेकिन इस सिस्टम के प्रशिक्षण के लिए उन तस्वीरों के साथ निर्देश और रोबोट की विस्तृत गति भी जोड़नी होती है।
लेखक मानव संचालन या पहनने योग्य रिकॉर्डिंग उपकरणों के जरिए प्रदर्शन जुटाने वाली कुछ विधियों में लगने वाले समय का जिक्र करते हैं:
चूंकि हर प्रसंग किसी व्यक्ति को खुद करके दिखाना होता है, इसलिए एक घंटे का डेटा जुटाने में कम से कम एक घंटे का मानवीय समय लगता है।
इसके बजाय HALO सिमुलेशन में मेल खाते उदाहरण तैयार करता है। प्रक्रिया में पहले किसी कार्य को गति के खंडों में बांटा जाता है। उदाहरण के लिए, आरामकुर्सी पर बैठने में आगे चलना, मुड़ना और सीट पर नीचे बैठना शामिल हो सकता है। टेक्स्ट निर्देश, रास्ते के वेपॉइंट और मुख्य मुद्राएं Kimodo नामक गति-निर्माण मॉडल का मार्गदर्शन करती हैं।
इसके बाद स्वचालित ज्यामितीय जांच संभावित गतिविधियों को पैरों के फिसलने, शरीर के फर्श के आर-पार जाने, अचानक उछलने और जोड़ों की सीमा से बाहर जाने जैसी समस्याओं के आधार पर अंक देती है। सबसे अच्छे संभावित विकल्प को चुनकर फिर एक वर्चुअल कमरे में रखा जाता है।
Infinigen नामक प्रक्रियात्मक दृश्य-निर्माता अलग-अलग बनावट और फर्नीचर वाले 1,000 परिवेश तैयार करता है, जिनमें बैठकखाने, दफ्तर और शयनकक्ष शामिल हैं। सिस्टम ऐसी जगहें तलाशता है जहां रोबोट की नियोजित गतिविधि और लक्ष्य वस्तु आसपास के फर्नीचर से टकराए बिना फिट हो सकें।
इसके बाद सिम्युलेटर कार्रवाई करते हुए रोबोट को दिखाई देने वाला दृश्य तैयार करता है। इसमें भौतिक सेटअप के अनुरूप सिम्युलेटेड फिशआई कैमरा इस्तेमाल होता है। रोशनी, एक्सपोजर, रंग, कंट्रास्ट, धुंधलापन और सेंसर के शोर में बदलाव से तस्वीरों में विविधता आती है। हर तैयार उदाहरण में एक निर्देश, कैमरे का दृश्य और उससे जुड़ी शरीर की गति शामिल होती है।
कंप्यूटिंग का खर्च और मानवीय काम
मुख्य प्रशिक्षण डेटा तैयार करने में Nvidia H100 के 250 ग्राफिक्स प्रोसेसर का इस्तेमाल करते हुए करीब 48 घंटे लगे। इन प्रोसेसरों को आम तौर पर GPU कहा जाता है। वे कई गणनाएं समानांतर रूप से करते हैं, जिससे बड़ी मात्रा में सिम्युलेटेड डेटा एक साथ तैयार किया जा सकता है।
क्रिया जनरेटर को अनुकरण-आधारित शिक्षण के जरिए प्रशिक्षित करने में Nvidia B200 के 64 GPU लगे। अनुकरण-आधारित शिक्षण में मॉडल उदाहरणों में दिखाए गए व्यवहार को दोहराना सीखता है। मोशन ट्रैकर के प्रशिक्षण में Nvidia H100 के चार GPU लगे और इसमें रीइन्फोर्समेंट लर्निंग के साथ पॉलिसी डिस्टिलेशन का इस्तेमाल किया गया।
रीइन्फोर्समेंट लर्निंग में नियंत्रक को प्रयासों और उसके प्रदर्शन के बारे में मिलने वाली प्रतिक्रिया के जरिए प्रशिक्षित किया जाता है। पॉलिसी डिस्टिलेशन सीखे हुए व्यवहार को दूसरे मॉडल में स्थानांतरित करता है। HALO में ये तरीके ट्रैकर को नियोजित मुद्राओं को ऐसी गतिविधियों में बदलने में मदद करते हैं, जिन्हें भौतिक रोबोट कर सके।
प्रक्रिया के कुछ हिस्सों को लोग अब भी तय करते हैं। कोई नया भौतिक कार्य जोड़ने के लिए निर्देश लिखने और मुख्य मुद्राएं तय करने की जरूरत होती है। कुछ गतिविधियां मानव वीडियो या मोशन-कैप्चर सामग्री पर भी निर्भर करती हैं। एक बार कार्य का विवरण और सीमाएं तय हो जाएं, तो प्रक्रिया उन्हें कई तैयार किए गए कमरों में दोबारा इस्तेमाल कर सकती है।
इसलिए बदलाव इस बात में है कि प्रदर्शनों की संख्या कैसे बढ़ाई जाती है। हर गतिविधि किसी व्यक्ति से करवाने के बजाय, HALO कंप्यूटिंग संसाधनों का इस्तेमाल किसी कार्य के कई रूप तैयार करने और उनकी जांच करने में करता है।
दृष्टि से संपर्क की समस्या पूरी तरह हल नहीं होती
शोधकर्ताओं के अनुसार HALO फिलहाल मुख्य रूप से दृष्टि पर निर्भर करता है और सीधे संपर्क महसूस नहीं कर सकता। जब किसी वस्तु के साथ काफी शारीरिक संपर्क की जरूरत हो और वह कैमरे के दृश्य से बाहर चली जाए या किसी दूसरी चीज के पीछे छिप जाए, तो प्रदर्शन घट सकता है।
डिब्बा धकेलना बताता है कि यह क्यों मायने रखता है। डिब्बे के चलते समय रोबोट को उसके सापेक्ष अपने शरीर की सही स्थिति बनाए रखनी होती है। कैमरा दिखाई दे रही स्थिति की जानकारी दे सकता है, जबकि स्पर्श-संवेदना संपर्क की ऐसी जानकारी दे सकती है जो दृश्य बाधित होने पर भी उपयोगी रहे।
शोधकर्ता आगे के काम की एक संभावित दिशा के रूप में स्पर्श-संवेदना का उल्लेख करते हैं। इसे जोड़ने के लिए कोई समयसीमा नहीं दी गई है। मौजूदा नतीजे चुनौती की स्पष्ट सीमा दिखाते हैं: HALO अपरिचित कमरों में दृष्टि-निर्देशित कई कौशल कर सकता है, जबकि लंबे क्रम और संपर्क वाली गतिविधियां अब भी कम भरोसेमंद हैं।
यह शोध क्या बदलता है
ऐपल का अध्ययन प्रशिक्षण डेटा निर्माण, भाषा-आधारित योजना और भौतिक नियंत्रण को एक ऐसे सिस्टम में जोड़ता है, जो ह्यूमनॉइड पर उन कमरों में चलता है जहां वह पहले नहीं गया। इसकी सबसे बड़ी उपलब्धि 1,000 सिम्युलेटेड परिवेशों से छह परीक्षण स्थलों की पहले से मैपिंग किए बिना 360 भौतिक परीक्षणों तक प्रशिक्षण का स्थानांतरण है।
जारी किया गया कोड सिमुलेशन और हार्डवेयर पर आगे के शोध के लिए इस प्रक्रिया को उपलब्ध कराता है। इसमें प्रशिक्षण उदाहरण बनाने के साधनों के साथ-साथ गति तैयार करने, ट्रैक करने और समन्वित करने के लिए जरूरी मॉडल और सॉफ्टवेयर भी शामिल हैं।
रोबोट से बैठने या डिब्बा हटाने को कहने वाले व्यक्ति के लिए विश्वसनीयता पूरी प्रक्रिया के साथ काम करने पर निर्भर करती है: सही वस्तु पहचानना, उस तक पहुंचना, संपर्क करना और गतिविधि पूरी करना। HALO के अलग-अलग कार्यों के नतीजे इस प्रक्रिया में प्रगति दिखाते हैं। क्रमों के नतीजे बताते हैं कि कई गतिविधियों को एक जैसी निरंतरता के साथ जोड़ने के लिए अभी और काम की जरूरत है।
मुख्य बिंदु
- ऐपल के शोधकर्ताओं ने Perceptive Humanoid Motion from Simulation को 4 नवंबर, 2026 को arXiv पर प्रस्तुत किया।
- HALO ने छह अपरिचित, बिना मैप किए वास्तविक परिवेशों में अलग-अलग कार्यों के 360 परीक्षणों में औसतन 91% सफलता हासिल की।
- एक अन्य वास्तविक परिवेश में तीन कार्य-संयोजनों ने 30 परीक्षणों में औसतन 70% सफलता हासिल की।
- सिस्टम में कार्य-योजना, गति-निर्माण और प्रति सेकंड 50 बार जोड़-संबंधी आदेश देने वाला ट्रैकर शामिल है।
- प्रशिक्षण में 1,000 तैयार किए गए परिवेशों के करीब 300 घंटे के कृत्रिम उदाहरण इस्तेमाल हुए।
- यूनिट्री G1 पर लगा Mac mini इंटरनेट कनेक्शन के बिना स्थानीय रूप से काम करने में सहायता करता है।
- प्रशिक्षण में मानवीय कार्य-डिजाइन अब भी शामिल है और सीमित संपर्क-संवेदना इसकी कमजोरी बनी हुई है।