RNA के अक्षरों और उनके आपसी संबंधों को सीखने वाला मॉडल
चीन के विज्ञान एवं प्रौद्योगिकी विश्वविद्यालय के शोधकर्ताओं ने structRFM जारी किया है। यह एक ओपन RNA फाउंडेशन मॉडल है, जिसे 2.1 करोड़ RNA अनुक्रमों और कंप्यूटेशनल तरीके से संरचना के लिए चिह्नित किए गए जोड़ों पर प्रशिक्षित किया गया है। इस रिलीज में जोड़े गए प्रशिक्षण डेटा, मॉडल वेट और सोर्स कोड शामिल हैं, जिससे अन्य प्रयोगशालाओं को इस काम को दोहराने और प्रणाली को अपनी जरूरत के मुताबिक ढालने के लिए सामग्री मिलती है।
विषय-सूची
- RNA के अक्षरों और उनके आपसी संबंधों को सीखने वाला मॉडल
- अनुक्रम जितना ही अहम क्यों है फोल्डिंग
- 2.1 करोड़ प्रशिक्षण जोड़े कैसे जुटाए गए
- छिपी जानकारी से मॉडल को सिखाना
- संरचना संबंधी परीक्षणों के नतीजे
- RNA प्रसंस्करण से कार्यात्मक वर्गीकरण तक
- ओपन रिलीज से शोधकर्ताओं को क्या मिलता है
- टीम और प्रकाशन की समयरेखा
- RNA शोध के लिए इन नतीजों का क्या मतलब है
- मुख्य बिंदु
4 नवंबर, 2026 को Nature में प्रकाशित अध्ययन में ऐसे मॉडल का वर्णन है, जो RNA के आणविक निर्माण खंडों के क्रम और उन संबंधों, दोनों को सीखता है जो इन अणुओं को मुड़ने में मदद करते हैं। तीन आयामी संरचनाओं की भविष्यवाणी के लिए इसके अनुकूलित रूप, Zfold, ने CASP15-natural, CASP16 और RNA-Puzzles के मूल्यांकनों में ऐसा प्रदर्शन किया जिसे लेखक AlphaFold3 के तुलनीय बताते हैं।
व्यावहारिक रूप से structRFM की खासियत यह है कि प्रशिक्षण के बाद इसे इनपुट के तौर पर केवल RNA अनुक्रम की जरूरत होती है। यह ऐसी जानकारी देता है जिसका उपयोग शोधकर्ता कई कामों में कर सकते हैं, जिनमें आणविक संरचना की भविष्यवाणी, RNA प्रसंस्करण में शामिल स्थलों की पहचान और RNA अणुओं का उनके कार्य के आधार पर वर्गीकरण शामिल है।
Nature में प्रकाशित structRFM शोधपत्र इस काम को अलग-अलग पूर्वानुमान कार्यों में संरचनात्मक जानकारी उपयोगी बनाने के एक तरीके के रूप में प्रस्तुत करता है। पेंग शियोंग और एस. केविन झोउ संबंधित लेखक हैं, जबकि हेछिन झू पहले लेखक हैं।
अनुक्रम जितना ही अहम क्यों है फोल्डिंग
RNA प्रोटीन निर्माण, जीन नियमन और आनुवंशिक संदेशों के प्रसंस्करण में भाग लेता है। इसका अनुक्रम इसके न्यूक्लियोटाइड का क्रम होता है। ये आणविक इकाइयां आम तौर पर A, U, C और G अक्षरों से दर्शाई जाती हैं। यह क्रम जानकारी रखता है, जबकि अणु के मुड़ने का तरीका यह तय करने में मदद करता है कि वह कैसे काम करेगा।
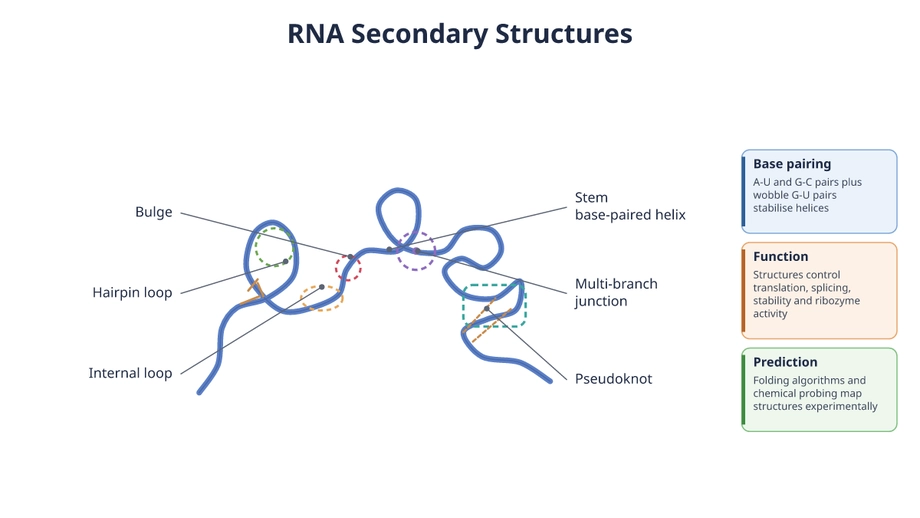
RNA की एक शृंखला के कुछ हिस्से उसी शृंखला के दूसरे हिस्सों के साथ जुड़ सकते हैं। इन संबंधों से द्वितीयक संरचना बनती है, जिसमें जुड़े हुए क्षेत्र, तने और लूप का एक खास पैटर्न होता है। फिर अणु मुड़कर तीन आयामी आकार लेता है, जिसे तृतीयक संरचना कहते हैं। यह आकार उसकी गतिविधि और दूसरे अणुओं के साथ उसकी अंतःक्रियाओं को प्रभावित करता है।
कई RNA भाषा मॉडल, भाषा मॉडल की तरह ही, अनुक्रमों के बड़े संग्रह से पैटर्न सीखते हैं। structRFM प्रशिक्षण के दौरान यह जानकारी भी जोड़ता है कि कौन-से न्यूक्लियोटाइड आपस में जुड़ते हैं। इससे उसे अनुक्रम में दूर-दूर स्थित स्थानों के बीच संबंध सीखने में मदद मिलती है।
शोधकर्ताओं का लक्ष्य फाउंडेशन मॉडल का लचीलापन बनाए रखना था: ऐसा व्यापक रूप से प्रशिक्षित सिस्टम, जिसकी सीखी हुई विशेषताओं को अलग-अलग उद्देश्यों के लिए अनुकूलित किया जा सके। उनका उद्देश्य फोल्डिंग की जानकारी को इस साझा आधार में शामिल करना था, न कि ऐसा सिस्टम प्रशिक्षित करना जो केवल एक संरचनात्मक कार्य में उपयोगी हो।
2.1 करोड़ प्रशिक्षण जोड़े कैसे जुटाए गए
टीम ने लगभग 2.1 करोड़ RNA अनुक्रम और द्वितीयक संरचना के जोड़ों वाला डेटासेट तैयार किया। संरचनात्मक टिप्पणियां कंप्यूटेशनल तरीके से बनाई गईं। इससे शोधकर्ता प्रयोगशाला में किए गए प्रयोगों से निर्धारित संरचनाओं के संग्रह की तुलना में कहीं बड़े पैमाने पर प्रशिक्षण दे सके।
कंप्यूटर से की गई भविष्यवाणियों में त्रुटियां हो सकती हैं और वे उन तरीकों की खूबियों व कमियों को दर्शा सकती हैं जिनसे उन्हें तैयार किया गया। किसी एक पूर्वानुमानकर्ता पर निर्भरता घटाने के लिए शोधकर्ताओं ने MUSES पेश किया, जो कई स्रोतों से बनी द्वितीयक संरचनाओं की एक एन्सेंबल विधि है। एन्सेंबल में किसी एक स्रोत पर पूरी तरह निर्भर रहने के बजाय कई पूर्वानुमान स्रोतों की जानकारी जोड़ी जाती है।
MUSES, अनुमानित संरचनाओं से मॉडल को सिखाने की एक बुनियादी समस्या का समाधान करता है: प्रशिक्षण टिप्पणियों में बार-बार होने वाली त्रुटियां मॉडल की सीख को प्रभावित कर सकती हैं। संरचनात्मक भविष्यवाणियों को जोड़ने का उद्देश्य बेस-पेयरिंग की उपयोगी जानकारी बनाए रखते हुए किसी एक पूर्वानुमानकर्ता के पक्षपात को कम करना था।
अध्ययन के प्रशिक्षण और मूल्यांकन संसाधन RNAcentral, Rfam और Protein Data Bank सहित स्थापित जैविक संग्रहों पर आधारित हैं। इसके डेटा विवरण में संबंधित संस्करण दिए गए हैं, जिनमें RNAcentral संस्करण 24.0 और Rfam संस्करण 14.10 तथा 15.0 शामिल हैं। इससे शोधकर्ता प्रयोगों में इस्तेमाल किए गए डेटासेट का पता लगा सकते हैं।
छिपी जानकारी से मॉडल को सिखाना
structRFM में मास्क्ड लैंग्वेज मॉडलिंग का उपयोग होता है। इस प्रशिक्षण विधि में इनपुट के कुछ हिस्से छिपा दिए जाते हैं और मॉडल आसपास के संदर्भ से गुम जानकारी हासिल करना सीखता है। RNA के मामले में इसका अर्थ शब्दों के बजाय न्यूक्लियोटाइड के बीच संबंध सीखना है।
टीम ने पेयर मैचिंग प्रक्रिया के जरिए बेस-पेयरिंग को इस प्रक्रिया में शामिल किया। डायनैमिक मास्किंग अनुपात, संरचनात्मक संबंधों से निर्देशित प्रशिक्षण और अलग-अलग न्यूक्लियोटाइड स्थानों पर मास्किंग के बीच संतुलन बनाता है। इससे मॉडल को स्थानीय अनुक्रम पैटर्न और फोल्डिंग से जुड़े संबंध, दोनों सीखने के अवसर मिलते हैं।
इससे बने मॉडल से तीन तरह की विशेषताएं मिलती हैं: पूरे अनुक्रम की जानकारी, हर न्यूक्लियोटाइड की जानकारी और न्यूक्लियोटाइड के जोड़ों की जानकारी। विशेषता एक संख्यात्मक निरूपण है, जिसका उपयोग कोई दूसरा पूर्वानुमान सिस्टम कर सकता है। अलग-अलग कार्य इस निरूपण के अलग-अलग स्तरों का इस्तेमाल कर सकते हैं।
शोधकर्ताओं ने एब्लेशन प्रयोग भी किए, जिनमें मॉडल के कुछ हिस्सों को हटाया या बदला जाता है ताकि उनके योगदान की जांच हो सके। इन प्रयोगों से रिपोर्ट किए गए सुधारों में संरचनात्मक जानकारी और मास्किंग रणनीति, दोनों के योगदान को समर्थन मिला। इससे structRFM के डिजाइन विकल्पों के पक्ष में प्रमाण मिला।
संरचना संबंधी परीक्षणों के नतीजे
जीरो-शॉट होमोलॉजी वर्गीकरण में structRFM ने मजबूत प्रदर्शन किया। होमोलॉजी से आशय साझा विकासवादी मूल से विरासत में मिले संबंधों से है। इस संदर्भ में जीरो-शॉट वर्गीकरण यह परखता है कि सीखी गई विशेषताएं ऐसे संबंधों को पहचानने में कितनी उपयोगी हैं, जबकि मॉडल को लक्षित वर्गीकरण कार्य पर विशेष रूप से प्रशिक्षित नहीं किया गया हो।
लेखकों ने द्वितीयक संरचना की भविष्यवाणी में सुधार और हाल में जारी किए गए RNA परिवारों पर मजबूत प्रदर्शन की भी जानकारी दी। RNA परिवार में साझा अनुक्रम या संरचनात्मक विशेषताओं वाले संबंधित अणु शामिल होते हैं। हाल में जारी परिवारों पर परीक्षण यह जांचता है कि स्थापित डेटासेट के परिचित समूहों से बाहर मॉडल कितना अच्छा काम करता है।
तृतीयक संरचना की भविष्यवाणी के लिए टीम ने structRFM की सीखी हुई विशेषताओं को तीन आयामी आकारों की भविष्यवाणी करने वाले मॉडल में अनुकूलित करके Zfold विकसित किया। लेखकों के मुताबिक, अनुमानित आकारों और उन भविष्यवाणियों से निकाली गई द्वितीयक संरचनाओं, दोनों में सुधार हुआ।
Zfold का मूल्यांकन CASP15-natural, CASP16 और RNA-Puzzles पर किया गया। ये आणविक संरचना की भविष्यवाणी को परखने के लिए इस्तेमाल होने वाले बेंचमार्क संग्रह हैं। इन सभी मूल्यांकनों में शोधपत्र ने इसके प्रदर्शन को AlphaFold3 के तुलनीय बताया है। यह तुलना इन नामित बेंचमार्क पर Zfold के नतीजों से संबंधित है, जबकि structRFM अंतर्निहित RNA निरूपण उपलब्ध कराता है।
अध्ययन में एक ऐसे सटीकता स्कोर के बजाय कई तरह की सफलताएं प्रस्तुत की गई हैं जो हर उपयोग को समेटे। संबंधित अनुक्रमों की पहचान करना, बेस पेयर की भविष्यवाणी करना और तीन आयामी आकार का पुनर्निर्माण करना अलग-अलग समस्याएं हैं और हर एक के लिए अलग मूल्यांकन जरूरी है।
RNA प्रसंस्करण से कार्यात्मक वर्गीकरण तक
structRFM को RNA के कार्य से जुड़े कामों पर भी परखा गया। इनमें स्प्लाइस साइट की भविष्यवाणी, इंटरनल राइबोसोम एंट्री साइट की पहचान और नॉन-कोडिंग RNA का वर्गीकरण शामिल था। इस तरह मूल्यांकन आणविक आकार से आगे बढ़ा।
स्प्लाइस साइट उन सीमाओं को चिह्नित करती हैं जिनका उपयोग कोशिकाएं RNA संदेशों को संसाधित करते समय करती हैं। स्प्लाइसिंग के दौरान कुछ चुने हुए हिस्से हटाए जाते हैं और बाकी हिस्से जोड़ दिए जाते हैं। इन सीमाओं की भविष्यवाणी से शोधकर्ताओं को यह जांचने में मदद मिलती है कि प्रोटीन बनाने में इस्तेमाल होने से पहले आनुवंशिक संदेश कैसे तैयार होता है।
इंटरनल राइबोसोम एंट्री साइट, यानी IRES तत्व, RNA के ऐसे क्षेत्र होते हैं जो प्रोटीन बनाने वाली कोशिकीय मशीनरी को बीच से ही ट्रांसलेशन शुरू करने देते हैं। इन्हें पहचानने के लिए अनुक्रम में कार्यात्मक पैटर्न समझना जरूरी है। इसलिए यह कार्य प्रीट्रेनिंग के दौरान हासिल की गई जानकारी की एक और परीक्षा है।
नॉन-कोडिंग RNA प्रोटीन निर्माण के टेम्पलेट के रूप में काम करने के अलावा अन्य भूमिकाएं निभाते हैं। उनका वर्गीकरण करने का अर्थ है अणुओं को संबंधित समूहों में रखना। लेखकों ने इन कार्यात्मक कामों में बेहतर प्रदर्शन की जानकारी दी। इससे पता चलता है कि जब पूर्वानुमान का लक्ष्य संरचना से बदलकर जैविक भूमिका हो गया, तब भी सीखी गई विशेषताएं उपयोगी रहीं।
टीम ने सेगमेंटेशन रणनीति के जरिए मॉडल को लंबे नॉन-कोडिंग RNA के वर्गीकरण के लिए भी विस्तारित किया। लंबे अनुक्रम को हिस्सों में बांटने से ऐसे इनपुट पर मॉडल का उपयोग संभव होता है जिन्हें एक ही इकाई के रूप में संसाधित करना मुश्किल होता।
ओपन रिलीज से शोधकर्ताओं को क्या मिलता है
इस रिलीज में तीन अलग-अलग उपयोग वाले संसाधन शामिल हैं। डेटासेट में सीखने के लिए इस्तेमाल किए गए उदाहरण हैं। मॉडल वेट में प्रशिक्षण के दौरान सीखे गए संख्यात्मक मान होते हैं। सोर्स कोड बताता है कि सॉफ्टवेयर कैसे लागू किया गया और कैसे चलाया जाता है।
वेट तक पहुंच से शोधकर्ता पूरा प्रीट्रेनिंग चरण दोहराने के बजाय पहले से प्रशिक्षित मॉडल पर काम कर सकते हैं। डेटा और कोड तक पहुंच से प्रशिक्षण प्रक्रिया की बारीकी से जांच, प्रयोगों को दोहराने और वैकल्पिक तरीके विकसित करने में मदद मिलती है।
शोधपत्र में परियोजना का GitHub रिपॉजिटरी heqin-zhu/structRFM बताया गया है। इसमें प्रीट्रेनिंग डेटासेट के लिए Zenodo संग्रह DOI 10.5281/zenodo.18272040 और सोर्स कोड तथा मॉडल चेकपॉइंट के लिए DOI 10.5281/zenodo.18274292 भी सूचीबद्ध हैं। DOI एक स्थायी पहचान संख्या है, जिसका उद्देश्य किसी शोध संसाधन को समय के साथ खोजने योग्य बनाए रखना है।
डेटा विवरण के अनुसार, प्रशिक्षण और परीक्षण डेटासेट परियोजना रिपॉजिटरी के जरिए सार्वजनिक रूप से उपलब्ध हैं। इसमें अध्ययन में इस्तेमाल किया गया संसाधित IRES विभाजन और आंकड़ों के पीछे का स्रोत डेटा भी दिया गया है। लेखकों का कहना है कि डेटा की उपलब्धता पर कोई प्रतिबंध नहीं है।
तुलना के लिए ये विवरण अहम हैं। शोधकर्ता देख सकते हैं कि कौन-से डेटासेट और विभाजन इस्तेमाल किए गए, मूल्यांकन फिर से चला सकते हैं और जांच सकते हैं कि प्रशिक्षण का कोई दूसरा विकल्प नतीजे बदलता है या नहीं। इस तरह यह रिलीज मॉडल के दोबारा उपयोग के साथ-साथ निष्कर्षों की जांच को भी समर्थन देती है।
टीम और प्रकाशन की समयरेखा
यह काम USTC के स्कूल ऑफ बायोमेडिकल इंजीनियरिंग और मेडिकल इमेजिंग, रोबोटिक्स, एनालिटिक कंप्यूटिंग एंड लर्निंग प्रयोगशाला के तहत किया गया, जिसे MIRACLE के नाम से जाना जाता है। लेखकों की संबद्धताओं में हेफेई और USTC के सूझोउ इंस्टीट्यूट फॉर एडवांस्ड रिसर्च शामिल हैं। सह-लेखक रूफेंग ली हांगझोउ स्थित झेजियांग विश्वविद्यालय के कॉलेज ऑफ कंप्यूटर साइंस एंड टेक्नोलॉजी से जुड़े हैं।
प्रोफेसर झोउ और विशेष शोध फेलो शियोंग ने अध्ययन की परिकल्पना तैयार की और उसका पर्यवेक्षण किया। झू ने फ्रेमवर्क तैयार किया और लागू किया, प्रीट्रेनिंग तथा संरचना की भविष्यवाणी और RNA वर्गीकरण के कई प्रयोग किए और नतीजों का विश्लेषण किया। टीम के अन्य सदस्यों ने होमोलॉजी परीक्षण, डेटासेट तुलना, IRES पहचान और संरचनात्मक मूल्यांकन पर काम किया।
इस काम का प्रकाशन और सार्वजनिक प्रस्तुतीकरण दो कैलेंडर तारीखों में हुआ:
- 4 नवंबर, 2026: Nature ने “सामान्यीकृत पूर्वानुमान के लिए एक ओपन संरचना-निर्देशित RNA फाउंडेशन मॉडल” के प्रकाशन की तारीख दर्ज की।
- 5 नवंबर, 2026: चीन में इस काम और इसकी ओपन रिलीज का प्रचार किया गया। ऑनलाइन प्रकाशन के तड़के के समय सामने आने की बात कही गई।
लेखकों ने चीन के नेशनल नेचुरल साइंस फाउंडेशन, नेशनल की R&D प्रोग्राम, जियांग्सू और सूझोउ के शोध कार्यक्रमों तथा शेनझेन के सानमिंग प्रोजेक्ट ऑफ मेडिसिन से मिले समर्थन की जानकारी दी है। उन्होंने कहा है कि हितों का कोई टकराव नहीं है।
RNA शोध के लिए इन नतीजों का क्या मतलब है
structRFM कई शोध गतिविधियों के लिए एक साझा शुरुआती आधार देता है। RNA प्रसंस्करण की जांच करने वाली प्रयोगशाला उसी मूल मॉडल को अपने काम के मुताबिक ढाल सकती है, जिसका उपयोग दूसरा समूह फोल्डिंग के अध्ययन या नॉन-कोडिंग अणुओं के वर्गीकरण के लिए करता है। हालांकि, हर उपयोग के लिए अपने कार्य के अनुरूप विकास और मूल्यांकन अब भी जरूरी है।
2.1 करोड़ प्रशिक्षण जोड़ों, संरचना-निर्देशित सीखने और जारी किए गए चेकपॉइंट के मेल से शोधकर्ताओं को जांचने के लिए एक ठोस सिस्टम मिलता है, केवल एल्गोरिदम का विवरण नहीं। MUSES और मास्किंग प्रयोग ऐसे विशिष्ट डिजाइन विकल्प भी देते हैं जिन्हें दूसरी टीमें परख या बदल सकती हैं।
रिपोर्ट किए गए निष्कर्ष कंप्यूटेशनल पूर्वानुमान और वर्गीकरण पर केंद्रित हैं। जैव-चिकित्सकीय उपयोगों की दिशा में आगे बढ़ने के लिए अतिरिक्त जैविक प्रयोग करने होंगे, जिनमें अनुमानित संरचनाओं की जांच और खास RNA अणुओं को दिए गए कार्यों का परीक्षण शामिल है।
शोधपत्र में किसी नैदानिक उपयोग की समयसीमा नहीं दी गई है। तत्काल बदलाव पहुंच का है: दुनियाभर के शोधकर्ता प्रशिक्षण संसाधन हासिल कर सकते हैं, कार्यान्वयन की जांच कर सकते हैं और अपने RNA डेटासेट पर रिपोर्ट किए गए सुधार लागू होते हैं या नहीं, इसका अध्ययन कर सकते हैं।
मुख्य बिंदु
- USTC के शोधकर्ताओं ने structRFM जारी किया है। इस RNA फाउंडेशन मॉडल को लगभग 2.1 करोड़ अनुक्रम और द्वितीयक संरचना के जोड़ों पर प्रशिक्षित किया गया।
- मॉडल अनुक्रम पैटर्न और बेस-पेयरिंग संबंध सीखता है और फिर केवल अनुक्रम इनपुट से विशेषताएं तैयार करता है।
- MUSES संरचना संबंधी कई पूर्वानुमान स्रोतों को जोड़ता है, जबकि डायनैमिक मास्किंग प्रशिक्षण के दौरान संरचनात्मक और न्यूक्लियोटाइड जानकारी में संतुलन बनाती है।
- लेखकों ने मजबूत होमोलॉजी वर्गीकरण और द्वितीयक संरचना की भविष्यवाणी में सुधार की जानकारी दी है, जिसमें हाल में जारी RNA परिवारों पर परीक्षण भी शामिल हैं।
- तृतीयक संरचना की भविष्यवाणी के लिए इसका अनुकूलित रूप Zfold, तीन नामित बेंचमार्क संग्रहों पर ऐसा प्रदर्शन करता है जिसे AlphaFold3 के तुलनीय बताया गया है।
- डेटासेट, मॉडल वेट, सोर्स कोड और मूल्यांकन संसाधन दोबारा उपयोग और प्रयोगों को दोहराने के लिए सार्वजनिक रूप से उपलब्ध हैं।