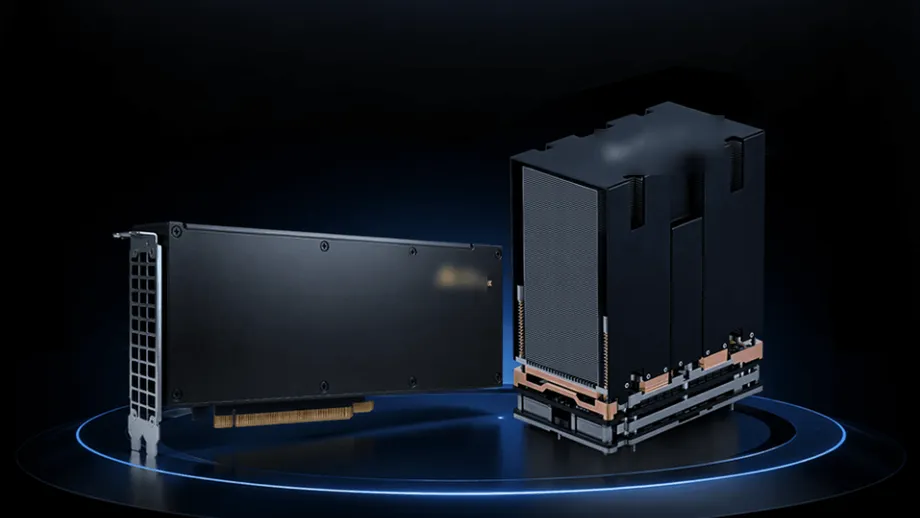
काम करता GPU और थ्रूपुट में 5% बढ़त का दावा
Iluvatar CoreX ने शंघाई में अपने Tiangai 300 ग्राफिक्स प्रोसेसर का सार्वजनिक प्रदर्शन किया। कंपनी ने इसे Nvidia के H200 का चीनी विकल्प बताते हुए तीसरे पक्ष के एक इन्फरेंस परीक्षण में 5% बढ़त का दावा किया। 28 अक्टूबर, 2026 को आयोजित मीडिया ओपन डे में कंपनी ने आठ GPU वाला ट्रेनिंग सिस्टम भी दिखाया और 144 GPU तथा 18 CPU वाले रैक का ब्योरा दिया।
विषय-सूची
- काम करता GPU और थ्रूपुट में 5% बढ़त का दावा
- H200 से तुलना में क्या मापा गया
- लंबे दस्तावेज और तेज शुरुआती जवाब
- ट्रेनिंग के नतीजों में Nvidia का अलग संदर्भ
- जुलाई में लॉन्च से अक्टूबर के प्रदर्शन तक
- 144 GPU के इर्द-गिर्द बना रैक
- अलग-अलग चिपों के बीच AI काम साझा करना
- सॉफ्टवेयर के दावों का लक्ष्य तैनाती में लगने वाला समय
- TY1200 से रोबोट तक पहुंचा कंपनी का दावा
- मुख्य बिंदु
Iluvatar CoreX के मुताबिक, सुर्खियों में आया यह तुलनात्मक नतीजा Shanghai Electric Group के जुलाई में किए गए परीक्षण से आया है। बड़े भाषा मॉडल की प्रोसेसिंग के दो चरणों को अलग करने वाली तैनाती में, नतीजों को प्रति कार्ड के आंकड़े में बदलने के बाद Tiangai 300 का एंड-टू-एंड थ्रूपुट H200 के 1.05 गुना के बराबर रहा।
थ्रूपुट का अर्थ है कि कोई सिस्टम तय समय में कितना उपयोगी काम पूरा करता है। चैटबॉट के मामले में इसका मतलब हो सकता है कि वह हर सेकंड कितने पाठ अंश तैयार करता है। संदर्भ प्रदर्शन का 1.05 गुना नतीजा, उस परीक्षण की परिस्थितियों में 5% अधिक आउटपुट दर्शाता है।
कंपनी ने Tiangai 300 को ऐसा पहला चीनी सामान्य-उद्देश्य वाला GPU बताया जिसने मापे गए परीक्षण में H200 के प्रदर्शन का स्तर हासिल किया। अक्टूबर के प्रदर्शन में भाषा मॉडल, इमेज जनरेशन और वीडियो जनरेशन की तुलना भी शामिल थी, जबकि एक अलग ट्रेनिंग प्रदर्शन में Nvidia के H100 को संदर्भ के रूप में इस्तेमाल किया गया।
इस आयोजन में केवल चिप के विनिर्देश ही पेश नहीं किए गए। Iluvatar CoreX ने कार्ड, सर्वर, उच्च घनत्व वाला रैक डिजाइन, सॉफ्टवेयर टूल और अलग-अलग प्रकार के प्रोसेसरों के बीच AI कार्य साझा करने की विधि प्रस्तुत की। कंपनी का व्यावसायिक दावा है कि इन चीजों से कम लागत और कम इंतजार में उपयोगी AI आउटपुट तैयार किया जा सकता है।
H200 से तुलना में क्या मापा गया
Shanghai Electric Group के जुलाई के परीक्षण में प्रीफिल और डिकोड को अलग किया गया था, जिसे अक्सर PD सेपरेशन कहा जाता है। प्रीफिल वह चरण है जब भाषा मॉडल उपयोगकर्ता के अनुरोध और उससे जुड़ी सामग्री को पढ़ता है। डिकोड वह चरण है जिसमें मॉडल एक-एक टोकन करके जवाब तैयार करता है। टोकन वे छोटे अंश हैं जिनमें AI सिस्टम पाठ को बांटते हैं।
इन चरणों को अलग करने से सिस्टम पढ़ने और लिखने के काम के लिए संसाधनों का आवंटन अलग-अलग तरीके से कर सकता है। इसलिए Tiangai 300 का यह नतीजा एक खास तैनाती व्यवस्था से जुड़ा है, जिसमें कुल प्रदर्शन को प्रति कार्ड के समतुल्य आंकड़े के रूप में व्यक्त किया गया।
Iluvatar CoreX ने तीसरे पक्ष के इस प्रमुख नतीजे के पीछे की विस्तृत परीक्षण विधि, मॉडल सूची या वर्कलोड की परिस्थितियां प्रकाशित नहीं की थीं। स्वतंत्र रूप से नतीजे को दोहराने के लिए इन जानकारियों के साथ रूपांतरण की गणना और सॉफ्टवेयर सेटिंग भी जरूरी हैं। लागत तुलना का विस्तृत ब्योरा भी प्रकाशित नहीं किया गया है, जबकि अलग-अलग कार्ड और पूरे रैक की मेमोरी क्षमता के आंकड़ों पर स्पष्टीकरण की जरूरत है।
प्रदर्शन प्रयोगशाला के नाम सहित दिए गए प्रदर्शनों से कंपनी के दावों की अधिक विस्तृत तस्वीर मिलती है। इनमें अलग-अलग कामों के लिए अलग-अलग स्तर के सुधार बताए गए हैं, मल्टीमीडिया जनरेशन में मामूली बढ़त से लेकर रिकमेंडेशन थ्रूपुट में बड़ी वृद्धि तक। खरीदार के लिए प्रासंगिक तुलना वही होगी जो उसके अपने सेवा-कार्य से मेल खाती हो।
लंबे दस्तावेज और तेज शुरुआती जवाब
कंपनी की प्रयोगशाला के मुताबिक, 64K कॉन्टेक्स्ट लंबाई पर Tiangai 300 का अटेंशन प्रदर्शन H200 के 1.05 गुना तक पहुंचा। अटेंशन वह प्रक्रिया है जो मॉडल को यह तय करने में मदद करती है कि उसके इनपुट के कौन-से हिस्से एक-दूसरे से कैसे जुड़े हैं। 64K कॉन्टेक्स्ट लंबाई का मतलब है कि मॉडल करीब 64,000 टोकन पर काम कर रहा है।
उसी कॉन्टेक्स्ट स्तर पर GLM-5.3 के लिए Iluvatar CoreX ने H200 के 1.15 गुना थ्रूपुट का दावा किया, जबकि उपयोगकर्ता अनुभव समकक्ष बनाए रखा गया। परीक्षण किए गए मिक्सचर-ऑफ-एक्सपर्ट्स वर्कलोड में यह 15% की बढ़त है। मिक्सचर-ऑफ-एक्सपर्ट्स मॉडल हर टोकन के लिए सभी नेटवर्क इस्तेमाल करने के बजाय काम को चुने हुए विशेषज्ञ नेटवर्कों को सौंपता है।
8K से 128K तक के कॉन्टेक्स्ट वाले AI एजेंट वर्कलोड में कंपनी ने पहले आउटपुट टोकन के इंतजार में लगभग 10% से 30% तक कमी की सूचना दी। यह आंकड़ा उस व्यक्ति के लिए अहम है जो किसी सहायक के जवाब शुरू करने का इंतजार कर रहा हो, जबकि सहायक लंबा दस्तावेज पढ़ रहा हो या जटिल अनुरोध संसाधित कर रहा हो।
इमेज और वीडियो जनरेशन भी प्रदर्शन का हिस्सा थे। कंपनी ने H200 की तुलना में मल्टीमॉडल जनरेशन थ्रूपुट में लगभग 2% से 5% की बढ़त बताई। ऑनलाइन सर्च, विज्ञापन और रिकमेंडेशन वर्कलोड में उसने रिकमेंडेशन इन्फरेंस थ्रूपुट 21% अधिक और हल्की गणना के लिए लेटेंसी 26% कम होने का दावा किया।
ट्रेनिंग के नतीजों में Nvidia का अलग संदर्भ
ट्रेनिंग प्रदर्शन में करीब 32 अरब पैरामीटर वाले Qwen3-32B मॉडल को आठ GPU सर्वर पर चलाया गया। पैरामीटर वे संख्यात्मक मान होते हैं जिन्हें मॉडल पैटर्न सीखने के लिए ट्रेनिंग के दौरान समायोजित करता है। Iluvatar CoreX ने कहा कि प्रति कार्ड प्रभावी थ्रूपुट Nvidia के H100 के 1.33 गुना तक पहुंचा।
इसलिए उस ट्रेनिंग प्रदर्शन में H100 की तुलना में बताई गई बढ़त 33% थी। आयोजन के अन्य हिस्सों में इन्फरेंस के नतीजों की तुलना H200 से की गई थी। आंकड़ों को समझने के लिए इन संदर्भ उत्पादों को अलग-अलग रखना जरूरी है।
ट्रेनिंग सिस्टम FP8 प्रिसिजन पर चला। FP8 में संख्याओं को आठ बिट के जरिए दर्ज किया जाता है, जिससे अधिक बिट वाले प्रारूपों की तुलना में स्थानांतरित और संसाधित किए जाने वाले डेटा की मात्रा घटती है। सीखने की गुणवत्ता बनाए रखने के लिए AI ट्रेनिंग सॉफ्टवेयर को इस कम प्रिसिजन का सावधानी से प्रबंधन करना पड़ता है।
Iluvatar CoreX ने पूरी क्षमता पर लंबे समय तक संचालन के दौरान स्टेप टाइम में 0.43% उतार-चढ़ाव की भी सूचना दी, जबकि Hopper आधारित संदर्भ सिस्टम में यह 0.76% था। स्टेप टाइम किसी काम की बार-बार दोहराई जाने वाली इकाई को पूरा करने में लगने वाला समय है। समय अधिक स्थिर रहने से ऑपरेटर अनुमान लगा सकते हैं कि व्यस्त सिस्टम कितना काम पूरा करेगा।
जुलाई में लॉन्च से अक्टूबर के प्रदर्शन तक
Tiangai 300 को जुलाई 2026 में World Artificial Intelligence Conference में औपचारिक रूप से पेश किया गया था। यह कंपनी के Tianshu आर्किटेक्चर पर आधारित है, इसमें Tensor Cores की नई पीढ़ी शामिल है और इसके ग्राफिक्स मेमोरी विनिर्देश 144GB हैं।
यह प्रोसेसर स्केलर, वेक्टर और टेंसर ऑपरेशन को सपोर्ट करता है। सरल शब्दों में, ये क्रमशः अलग-अलग संख्याओं, संख्याओं के समूहों और बड़े गणितीय ऐरे पर काम करते हैं। समर्थित संख्यात्मक प्रारूपों में FP4, FP8, FP16 और BF16 शामिल हैं, जिससे सॉफ्टवेयर डेवलपर गति, मेमोरी उपयोग और संख्यात्मक प्रिसिजन के लिए अलग-अलग विकल्प चुन सकते हैं।
कंपनी के बताए सार्वजनिक पड़ाव कई महीनों में फैले हैं:
- जुलाई 2026: World Artificial Intelligence Conference में Tiangai 300 लॉन्च किया गया।
- जुलाई 2026: H200 थ्रूपुट तुलना के लिए उद्धृत तीसरे पक्ष का परीक्षण Shanghai Electric Group ने पूरा किया।
- अक्टूबर के मीडिया कार्यक्रम से पहले: IXL144 रैक डिजाइन China International Industry Fair में दिखाया गया।
- 28 अक्टूबर, 2026: Iluvatar CoreX ने शंघाई में मीडिया के लिए Tiangai 300 हार्डवेयर के लाइव प्रदर्शन शुरू किए।
अक्टूबर के आयोजन में उत्पाद की प्रस्तुति आर्किटेक्चर पर चर्चा से आगे बढ़कर नामित वर्कलोड चलाने वाले सिस्टम तक पहुंची। कंपनी के बताए तैनाती विकल्प अब अलग-अलग एक्सेलरेटर कार्ड से लेकर आठ कार्ड वाले सर्वर और बड़े IXL144 सिस्टम तक फैले हैं।
144 GPU के इर्द-गिर्द बना रैक
Iluvatar CoreX के मुताबिक, IXL144 एक मानक रैक में 144 GPU और 18 CPU को जोड़ता है। इसमें GPU मेमोरी कुल मिलाकर करीब 10.1TB है। कंपनी ने इसे उद्योग का सबसे अधिक घनत्व वाला ऐसा GPU सुपरनोड बताया जिसे एक ही रैक में रखा गया है। सुपरनोड में कई प्रोसेसरों को पास-पास जोड़ा जाता है, ताकि वे बड़े कामों पर साथ मिलकर काम कर सकें।
हर Tiangai 300 के लिए बताए गए 144GB विनिर्देश और रैक की कुल 10.1TB क्षमता के बीच तालमेल बैठाने के लिए कॉन्फिगरेशन का अधिक स्पष्ट ब्योरा जरूरी है। 144 कार्ड को 144GB से गुणा करने पर, क्षमता गिनने के तरीके में अंतर को छोड़कर, 20,736GB आता है। रैक के ब्योरे में कार्डों का कॉन्फिगरेशन और वर्कलोड के लिए उपलब्ध मेमोरी क्षमता स्पष्ट की जानी चाहिए।
Iluvatar CoreX का अनुमान है कि मुख्यधारा के अंतरराष्ट्रीय सिस्टम की तुलना में यह सिस्टम प्रति दस लाख प्रभावी टोकन की लागत करीब 40% घटा सकता है। प्रभावी टोकन से आशय उस आउटपुट से है जिसे उपयोगी काम के रूप में गिना जाता है। AI सेवाएं बेचने वाले ऑपरेटरों के लिए यह माप हार्डवेयर खर्च को तैयार किए गए उपयोगी आउटपुट की मात्रा से जोड़ता है।
40% की कमी का अर्थ होगा कि संदर्भ सिस्टम पर जिस काम की लागत 100 इकाई है, उसकी लागत यहां 60 इकाई होगी। वास्तविक बचत उपकरण की कीमत, बिजली की खपत, सॉफ्टवेयर, वर्कलोड और GPU कितनी निरंतरता से व्यस्त रहते हैं, इस पर निर्भर करेगी।
कंपनी ने अपनी अगली पीढ़ी के पीयर-टू-पीयर इंटरकनेक्ट इंजन के लिए एक लक्ष्य भी बताया: कनेक्टेड डोमेन में एक ट्रांसफर का समय 3 से 5 माइक्रोसेकंड से घटाकर 1 माइक्रोसेकंड करना। तेज संचार तब मददगार होता है जब अलग-अलग GPU मॉडल के अलग-अलग हिस्से संभालते हैं और उन्हें बार-बार डेटा का आदान-प्रदान करना पड़ता है।
अलग-अलग चिपों के बीच AI काम साझा करना
Iluvatar CoreX की विविध-प्रोसेसर तैनाती पद्धति में इन्फरेंस के अलग-अलग हिस्से अलग-अलग प्रकार के प्रोसेसरों को सौंपे जाते हैं। उसकी AFD सेपरेशन योजना के तहत Tiangai 300 पूरा प्रीफिल चरण और डिकोडिंग के दौरान अटेंशन गणनाएं संभालता है। एक भागीदार का XPU फीड-फॉरवर्ड एक्सपर्ट नेटवर्क संभालता है।
XPU दूसरे प्रकार के कंप्यूटिंग एक्सेलरेटर के लिए इस्तेमाल किया जाने वाला व्यापक नाम है। मूल विचार यह है कि हर प्रोसेसर को वही काम दिया जाए जिसे वह सबसे अच्छी तरह संभालता है, जबकि एक साझा शेड्यूलर पूरे काम का तालमेल करे। फीड-फॉरवर्ड नेटवर्क भाषा मॉडल के भीतर गणितीय प्रोसेसिंग का एक और बड़ा हिस्सा पूरा करते हैं।
कंपनी ने एकीकृत शेड्यूलिंग के तहत डिकोडिंग इन्फरेंस लेटेंसी में 60% कमी की सूचना दी। यह H200 के मुकाबले थ्रूपुट में 5% बढ़त वाले प्रमुख दावे से अलग सिस्टम कॉन्फिगरेशन है और इसमें प्रदर्शन का माप भी अलग है।
कंपनी के AI और त्वरित कंप्यूटिंग प्रमुख Shan Tianyi ने कहा कि भविष्य के AI कंप्यूटिंग सिस्टम इस बात पर निर्भर करेंगे कि अलग-अलग चिपों को कितनी कुशलता से व्यवस्थित किया जाता है, न कि हर काम के लिए केवल एक प्रकार के प्रोसेसर पर निर्भर रहने पर। AFD प्रदर्शन में GPU और भागीदार के एक्सेलरेटरों की एक ठोस व्यवस्था दिखाई गई।
सॉफ्टवेयर के दावों का लक्ष्य तैनाती में लगने वाला समय
Iluvatar CoreX ने तैनाती और ऑप्टिमाइजेशन के कुछ हिस्सों को स्वचालित करने के उद्देश्य से AI फॉर AI सॉफ्टवेयर स्टैक भी पेश किया। कंपनी ने कहा कि एनवायरनमेंट सेटअप का काम एक घंटे से घटकर 10 मिनट रह गया, जबकि मैनुअल ऑपरेशन की संख्या दर्जनों से घटकर एक हो गई।
एक बड़े मॉडल के ऑप्टिमाइजेशन के काम में कंपनी ने बताया कि काम का चक्र सात दिन से घटकर दो घंटे से कम रह गया और प्रदर्शन पहले के स्तर से करीब दोगुना हो गया। ये उदाहरण हार्डवेयर पर मॉडल को कुशलता से चलाने के लिए जरूरी इंजीनियरिंग कार्य से जुड़े हैं।
कंपनी ने GPU कंप्यूटिंग रूटीन विकसित करने के लिए इस्तेमाल होने वाली भाषा FlyDSL के साथ गहरे एकीकरण का भी दावा किया। उसने कहा कि कंपाइलेशन की गति 90% से अधिक बढ़ी और बताया कि पहले 10 लोगों को एक दिन लगने वाला काम अब एक व्यक्ति कुछ घंटों में पूरा कर सकता है।
सॉफ्टवेयर सपोर्ट इसलिए महत्वपूर्ण है क्योंकि प्रोसेसर को केवल सक्षम गणना हार्डवेयर से काम नहीं चलता। मॉडल, गणितीय लाइब्रेरी और तैनाती टूल को साथ मिलकर काम करना होता है। सॉफ्टवेयर के प्रदर्शनों से पता चलता है कि नए GPU को चालू सेवा में बदलने से पहले ग्राहकों को कितना इंजीनियरिंग काम करना पड़ सकता है।
TY1200 से रोबोट तक पहुंचा कंपनी का दावा
शंघाई के आयोजन में Tongyang TY1200 भी पेश किया गया। यह AI PC और एम्बॉडिड इंटेलिजेंस के लिए बनाया गया अलग प्रोसेसर है, जिसमें भौतिक दुनिया को महसूस करने और उसमें कार्रवाई करने वाले रोबोट भी शामिल हैं। इसकी बताई गई डेंस कंप्यूट क्षमता 300 TOPS, यानी प्रति सेकंड 300 ट्रिलियन ऑपरेशन है। डेंस कंप्यूट में शून्य मानों से जुड़ी गणनाओं को छोड़कर होने वाले काम को गिना जाता है।
Iluvatar CoreX ने Qwen3.8-27B और Qwen3.6-35B-A3B के परीक्षणों में TY1200 के Nvidia Thor T5000 के 1.2 गुना प्रदर्शन तक पहुंचने का दावा किया। भौतिक AI परिदृश्यों में Cosmos-R2-2B और Cosmos-R2-8B मॉडल के लिए कंपनी ने क्रमशः Thor T5000 के संदर्भ प्रदर्शन का 158% और 180% प्रदर्शन बताया।
कंपनी ने यह भी कहा कि TY1200, MuJoCo-Warp का इस्तेमाल करके GPU-त्वरित भौतिकी सिमुलेशन चला सकता है। इससे रोबोट विकास सिस्टम को गतिविधियों का सिमुलेशन करने, कंट्रोल पॉलिसी को ट्रेन करने और स्थानीय स्तर पर कार्रवाइयों की जांच करने की सुविधा मिलती है। कंट्रोल पॉलिसी सीखे गए निर्देशों का वह समूह है जिसका इस्तेमाल रोबोट अपनी गतिविधि तय करने के लिए करता है।
बताए गए उपयोगों में चिकित्सा मुलाकातों के दौरान लोगों की सहायता करने वाले रोबोट, औद्योगिक विजन और आगंतुकों का मार्गदर्शन शामिल हैं। अगले मॉडल TY2000 के लिए 600T की कंप्यूट क्षमता का लक्ष्य बताया गया है। ये उत्पाद मिलकर कंपनी की रणनीति को बड़े AI सर्वर से आगे उन उपकरणों तक ले जाते हैं जो उपयोगकर्ताओं और मशीनों के करीब काम करते हैं।
मुख्य बिंदु
- Iluvatar CoreX ने 28 अक्टूबर, 2026 को शंघाई में Tiangai 300 हार्डवेयर का प्रदर्शन किया।
- कंपनी ने प्रति कार्ड Nvidia H200 के 1.05 गुना के बराबर थ्रूपुट के लिए Shanghai Electric Group के परीक्षण का हवाला दिया।
- आठ GPU पर Qwen3-32B ट्रेनिंग प्रदर्शन में FP8 प्रिसिजन पर प्रति कार्ड H100 के 1.33 गुना थ्रूपुट मिलने की सूचना दी गई।
- प्रमुख तीसरे पक्ष के बेंचमार्क के पीछे की विस्तृत विधि प्रकाशित नहीं की गई है।
- IXL144 रैक में 144 GPU और 18 CPU हैं। कंपनी ने प्रति दस लाख प्रभावी टोकन की लागत में 40% कमी का दावा किया है।
- GPU और XPU के बीच काम साझा करने वाली एक अलग तैनाती में डिकोडिंग लेटेंसी 60% घटने की सूचना दी गई।
- आयोजन में सॉफ्टवेयर ऑटोमेशन और स्थानीय AI तथा रोबोटिक्स सिमुलेशन में TY1200 के उपयोग भी शामिल थे।