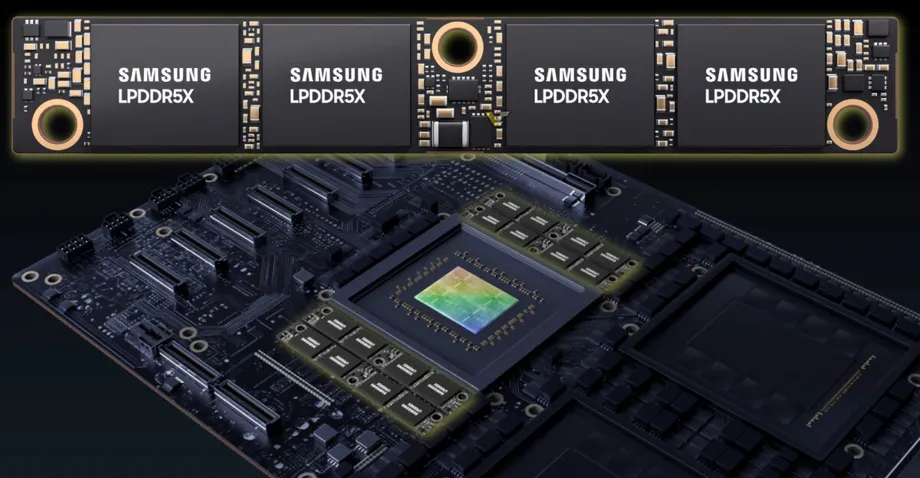
जीपीयू बढ़ाए बिना एआई अनुरोधों की संख्या बढ़ाना
सैमसंग इलेक्ट्रॉनिक्स ने मेमोरी आवंटित करने और प्रोसेसरों के बीच डेटा भेजने का तरीका बदलकर एआई सर्वरों पर एक साथ अधिक अनुरोधों को संभालने की विधि विकसित की है। प्रकाशित पेटेंट आवेदन में ऐसे सॉफ्टवेयर का वर्णन है जो प्रतीक्षा समय, डेटा स्थानांतरण की लागत और मेमोरी की भविष्य की जरूरतों को ध्यान में रखकर तय करता है कि बड़े भाषा मॉडल को किन अनुरोधों पर पहले काम करना चाहिए।
विषय-सूची
- जीपीयू बढ़ाए बिना एआई अनुरोधों की संख्या बढ़ाना
- मेमोरी जवाब देने में बाधा क्यों बन सकती है
- पेटेंट वाली शेड्यूलिंग विधि कैसे काम करती है
- स्टोरेज ऑफलोडिंग में सैमसंग ने क्या मापा
- तेज़ शुरुआत और ज्यादा तैयार किया गया टेक्स्ट
- अतिरिक्त स्टोरेज कब लागत वसूल करता है
- बिजली की बचत से कूलिंग पंखे भी चलते हैं धीमे
- स्टोरेज को अचानक बढ़ने वाले भार को संभालना होगा
- Samsung SDS गणना को मेमोरी के भीतर ले जाता है
- मुख्य बातें
इसका लक्ष्य ग्राफिक्स प्रोसेसिंग यूनिट (GPU) की मेमोरी भरने पर होने वाली देरी कम करना है, ताकि मौजूदा सर्वर अधिक लोगों को सेवा दे सकें। सैमसंग इस आविष्कार को एआई इन्फरेंस के लिए बुनियादी ढांचे की तकनीक बताता है। इन्फरेंस वह प्रक्रिया है जिसमें प्रशिक्षित मॉडल सवालों के जवाब देता है। यह किसी खास उपभोक्ता उत्पाद का फीचर नहीं है।
सैमसंग के संबंधित शोध से बेहतर मेमोरी प्रबंधन की संभावित बचत का ठोस अंदाजा मिलता है। आठ NVIDIA H100 NVL GPU और दस सैमसंग सॉलिड स्टेट ड्राइव वाले एक अलग स्टोरेज प्रयोग में, सैमसंग ने एक साथ 240 उपयोगकर्ताओं तक के लिए पहला आउटपुट टोकन आने की प्रतीक्षा एक सेकंड से कम रखी। स्टोरेज ऑफलोडिंग के बिना यह प्रतीक्षा समय 140 से अधिक उपयोगकर्ताओं पर बढ़ने लगा।
पेटेंट, स्टोरेज प्रयोग और Samsung SDS की एक अन्य परियोजना, तीनों एक ही समस्या के अलग-अलग पहलुओं को संबोधित करते हैं: महंगे एआई प्रोसेसर जानकारी को इधर-उधर भेजने या दोबारा तैयार करने में जरूरत से ज्यादा समय लगा सकते हैं। ऑपरेटरों के लिए यह काम घटाने का मतलब मौजूदा उपकरणों से अधिक जवाब और हर टोकन की कम लागत हो सकता है। टोकन टेक्स्ट के वे छोटे हिस्से हैं जिन्हें भाषा मॉडल प्रोसेस और जनरेट करते हैं।
मेमोरी जवाब देने में बाधा क्यों बन सकती है
GPU एक साथ कई गणनाएं करता है, इसलिए एआई जवाब तैयार करने में उपयोगी है। हालांकि, उसकी तेज स्थानीय मेमोरी की क्षमता सीमित होती है। कई बातचीत उस जगह के लिए प्रतिस्पर्धा करती हैं, खासकर जब उपयोगकर्ता लंबे दस्तावेज भेजते हैं या ऐसे सवाल पूछते हैं जिनके जवाब लंबे हों।
भाषा मॉडल अपनी पिछली गणनाओं का अस्थायी रिकॉर्ड एक संरचना में रखते हैं, जिसे की-वैल्यू कैश कहते हैं और आम तौर पर KV कैश लिखते हैं। इसे कामचलाऊ नोट्स की तरह समझें: इन नोट्स को रखने से मॉडल पहले से प्रोसेस की गई जानकारी की सारी गणनाएं बार-बार किए बिना जवाब आगे जारी रख सकता है।
सैमसंग के स्टोरेज प्रयोग में हर सत्र के लिए लगभग 3 GB KV कैश की जरूरत थी। 240 सत्रों में पूरे कार्यभार के लिए यह करीब 720 GB कैश डेटा होता है। यह आंकड़ा बताता है कि पर्याप्त कंप्यूटिंग क्षमता लगे होने के बावजूद बड़ी संख्या में लोगों को सेवा देना मेमोरी की समस्या क्यों बन सकता है।
तेज GPU मेमोरी कम पड़ने पर सर्वर कुछ डेटा केंद्रीय प्रोसेसिंग यूनिट (CPU) से जुड़ी मेमोरी में भेज सकता है और जरूरत पड़ने पर उसे वापस ला सकता है। इन स्थानांतरणों में समय लगता है। हटाई गई गणनाओं को दोबारा तैयार करने में भी संसाधन खर्च होते हैं। सैमसंग का पेटेंट इस प्रतिस्पर्धा को अधिक सावधानी से संभालने पर केंद्रित है।
पेटेंट वाली शेड्यूलिंग विधि कैसे काम करती है
सैमसंग का आवेदन, जिसका शीर्षक Method and Server for Processing Multiple User Requests of a Large Language Model है, ऐसे शेड्यूलर का वर्णन करता है जो हर अनुरोध को पूरा करने की लागत पर विचार करता है। इसके इनपुट में उपयोगकर्ता ने कितनी देर प्रतीक्षा की है, डेटा स्थानांतरण में कितना समय लगेगा और अनुरोध को कितनी मेमोरी चाहिए, ये बातें शामिल हैं।
सर्वर इन गणनाओं के आधार पर प्रोसेसिंग का क्रम तय करता है। यह इसलिए अहम है क्योंकि कोई अनुरोध चलने के लिए तैयार दिख सकता है, लेकिन पहले उसके लिए काफी डेटा स्थानांतरित करना पड़ सकता है; वहीं किसी दूसरे अनुरोध को पास में मौजूद डेटा से पूरा किया जा सकता है। इन फैसलों में तालमेल से मेमोरी को बार-बार व्यवस्थित करने में लगने वाला समय घट सकता है।
यह विधि यह भी जांचती है कि CPU मेमोरी में पहले स्थानांतरित की गई जानकारी अब भी मौजूद है या नहीं। अगर इस्तेमाल के लायक कॉपी मौजूद हो, तो सर्वर सब कुछ फिर से कॉपी करने के बजाय सिर्फ जरूरी हिस्से भेज सकता है। GPU जब एक उपयोगकर्ता का जवाब तैयार कर रहा हो, उसी दौरान वह दूसरे उपयोगकर्ता के लिए डेटा स्थानांतरित भी कर सकता है। इससे तैयारी और उपयोगी काम साथ-साथ हो सकते हैं।
सैमसंग आंशिक रूप से उपलब्ध मेमोरी का इस्तेमाल करने का तरीका भी बताता है। अगर नए अनुरोध को पांच इकाई जगह चाहिए, लेकिन केवल तीन खाली हैं, तो सिस्टम पांचों के उपलब्ध होने का इंतजार करने के बजाय जगह में समाने वाला हिस्सा शुरू कर सकता है। व्यावहारिक लक्ष्य व्यस्त समय में सीमित संसाधनों का उपयोग जारी रखना है। इस पेटेंट वाली विधि के व्यावसायिक इस्तेमाल का विवरण और प्रतिक्रिया समय तथा थ्रूपुट में मापे गए सुधार सार्वजनिक नहीं किए गए हैं।
स्टोरेज ऑफलोडिंग में सैमसंग ने क्या मापा
सैमसंग इलेक्ट्रॉनिक्स का KV कैश पर श्वेतपत्र एक अलग तरीके की पड़ताल करता है: दोबारा इस्तेमाल किए जा सकने वाले कैश डेटा को NVMe सॉलिड स्टेट ड्राइव पर रखना। NVMe ऐसी तकनीक है जिससे स्टोरेज डिवाइस PCIe कनेक्शन के जरिए कंप्यूटर से तेज़ी से संवाद कर सकते हैं।
परीक्षण में आठ NVIDIA H100 NVL GPU, समानांतर चलने वाली आठ LLaMA-3.1 8B इन्फरेंस सेवाएं, vLLM सर्विंग सॉफ्टवेयर और LMCache का इस्तेमाल किया गया। LMCache एक ओपन सोर्स परत है जो दोबारा इस्तेमाल किए जा सकने वाले KV कैश डेटा का प्रबंधन करती है। दस सैमसंग PM1753 ड्राइव को RAID-0 ऐरे में जोड़ा गया, जो स्थानांतरण प्रदर्शन बढ़ाने के लिए डेटा को कई ड्राइव में बांटता है।
सैमसंग ने उपयोगकर्ताओं का भार 20-20 की वृद्धि में मापा और एक साथ 280 उपयोगकर्ताओं तक पहुंचा। हर उपयोगकर्ता ने हर 20 सेकंड में एक क्वेरी भेजी, जिससे प्रति सेकंड एक से 14 क्वेरी तक का कार्यभार बना। इस तरह प्रयोग में बार-बार आने वाले अनुरोधों और कैश के स्थानांतरण के एक निश्चित पैटर्न की जांच की गई।
जब कोई सत्र एक GPU से दूसरे GPU पर जाता है, तब स्टोरेज वाला तरीका उपयोगी होता है। गंतव्य GPU लंबे प्रॉम्प्ट की शुरुआती प्रोसेसिंग दोहराने के बजाय सहेजी गई गणनाएं फिर से लोड कर सकता है। एक मशीन के भीतर बाहरी कैश CPU मेमोरी या स्टोरेज में रखा जा सकता है। कई मशीनों के बीच, सैमसंग के मुताबिक, कैश के लिए ऐसा साझा संसाधन चाहिए जो संबंधित सर्वरों की पहुंच में हो।
तेज़ शुरुआत और ज्यादा तैयार किया गया टेक्स्ट
सैमसंग ने सेवा प्रदर्शन के दो पहलू मापे: पहला टोकन आने का समय और प्रति सेकंड टोकन की संख्या। पहला माप बताता है कि जवाब दिखना शुरू होने से पहले व्यक्ति को कितनी देर इंतजार करना पड़ता है। दूसरा बताता है कि सिस्टम समय के साथ कितना टेक्स्ट तैयार करता है।
स्टोरेज ऑफलोडिंग चालू रहने पर, परीक्षण में एक साथ 240 उपयोगकर्ताओं तक पहला टोकन आने का समय एक सेकंड से कम रहा। इसकी तुलना में, ऑफलोडिंग के बिना 140 से अधिक उपयोगकर्ताओं पर विलंबता बढ़ने लगी। सैमसंग के मुताबिक, समान विलंबता पर 1.7 गुना अधिक उपयोगकर्ताओं को सेवा दी जा सकी। 20 से 140 उपयोगकर्ताओं के बीच ऑफलोडिंग वाले कॉन्फिगरेशन में शुरुआती प्रतीक्षा लगभग आधा सेकंड रही।
240 उपयोगकर्ताओं पर ऑफलोडिंग वाले सिस्टम ने करीब 1.5 गुना अधिक आउटपुट टोकन तैयार किए। ऑफलोडिंग के बिना कॉन्फिगरेशन में लगभग 160 उपयोगकर्ताओं पर संतृप्ति शुरू हो गई, जबकि सहेजे गए कैश का दोबारा इस्तेमाल करने वाला सिस्टम मांग बढ़ने के साथ अपना आउटपुट बढ़ाता रहा।
सैमसंग इस बढ़त का श्रेय प्रॉम्प्ट को बार-बार प्रोसेस करने की जरूरत घटने को देता है। भाषा मॉडल पहले इनपुट प्रोसेस करता है, इस चरण को प्रीफिल कहते हैं। इसके बाद वह डिकोड नाम के चरण में एक-एक टोकन करके जवाब तैयार करता है। सहेजी गई गणनाओं का दोबारा इस्तेमाल करने से जवाब तैयार करने के लिए GPU की अधिक क्षमता उपलब्ध रहती है।
अतिरिक्त स्टोरेज कब लागत वसूल करता है
सैमसंग के लागत विश्लेषण से पता चलता है कि अतिरिक्त हार्डवेयर की कीमत होती है, भले ही भारी मांग के दौरान उससे दक्षता बढ़े। एक साथ शून्य से 160 उपयोगकर्ताओं के दायरे में, दोनों कॉन्फिगरेशन ने प्रति सेकंड टोकन का लगभग समान थ्रूपुट दिया। वहीं ऑफलोडिंग वाले कॉन्फिगरेशन की लागत करीब 4% अधिक रही, क्योंकि उसमें अतिरिक्त NVMe घटक लगे थे।
180 से अधिक उपयोगकर्ताओं पर ज्यादा आउटपुट से अतिरिक्त स्टोरेज की लागत की भरपाई हुई। 240 उपयोगकर्ताओं पर सैमसंग ने तीन साल की परिचालन अवधि में प्रति डॉलर प्रति सेकंड टोकन के हिसाब से लागत दक्षता लगभग 1.5 गुना बेहतर आंकी।
दूसरे शब्दों में, प्रति डॉलर आउटपुट में 1.5 गुना सुधार का अर्थ इस गणना के तहत प्रति आउटपुट इकाई लागत में करीब एक-तिहाई कमी है। यह तुलना सैमसंग के परीक्षण किए गए उपकरणों और कार्यभार से जुड़ी है। किसी सेवा की वास्तविक अर्थव्यवस्था उसके मॉडल, बातचीत की लंबाई, ट्रैफिक और उपकरणों की लागत पर भी निर्भर करती है।
इसलिए क्लाउड ऑपरेटर के लिए व्यावहारिक फैसला मांग पर निर्भर करता है। अगर मौजूदा GPU क्षमता कार्यभार को आसानी से संभाल रही हो, तो अतिरिक्त स्टोरेज से शुरुआती बिल बढ़ सकता है। लगातार भीड़ के दौरान कैश का दोबारा इस्तेमाल उसी GPU इंस्टॉलेशन को नया सर्वर लगाने से पहले अधिक काम संभालने में मदद कर सकता है।
बिजली की बचत से कूलिंग पंखे भी चलते हैं धीमे
सैमसंग ने अपने स्टोरेज प्रयोग में बिजली की कम खपत भी मापी। 240 उपयोगकर्ताओं पर प्रति वॉट प्रदर्शन लगभग 2.9 गुना बेहतर हुआ। कुल सिस्टम बिजली की खपत ऑफलोडिंग के बिना वाले कॉन्फिगरेशन की करीब 53% रह गई, यानी लगभग 47% की कमी।
श्वेतपत्र के मुताबिक, अतिरिक्त NVMe ड्राइव से बिजली की खपत करीब 6% बढ़ी। GPU और कूलिंग की कम मांग ने इस बढ़ोतरी से ज्यादा बचत की। जब कार्यभार में बार-बार गहन प्रीफिल गणनाएं करने की जरूरत घटी, तब सैमसंग ने GPU उपयोग करीब 49% दर्ज किया।
कूलिंग पंखों में भी यह बदलाव दिखा। ऑफलोडिंग के बिना सिस्टम के सभी पंखे अपनी अपेक्षित अधिकतम गति, 15,000 चक्कर प्रति मिनट, पर चले। ऑफलोडिंग के साथ CPU, मेमोरी और स्टोरेज को ठंडा करने वाले पंखे करीब 7,800 चक्कर प्रति मिनट पर चले, जबकि GPU वाले हिस्से के पंखे लगभग 9,800 चक्कर प्रति मिनट पर रहे।
यह नतीजा दिखाता है कि कोई घटक स्थानीय स्तर पर बिजली की मांग बढ़ा सकता है, लेकिन पूरे सर्वर की खपत घटा सकता है। इस प्रयोग में सहेजी गई गणनाएं वापस पाने में ऊर्जा खर्च करने से गणनाएं दोहराने और उनसे पैदा हुई गर्मी हटाने की बड़ी ऊर्जा लागत कम हुई।
स्टोरेज को अचानक बढ़ने वाले भार को संभालना होगा
सैमसंग के माप यह भी दिखाते हैं कि इस तरीके के लिए केवल अतिरिक्त ड्राइव क्षमता पर्याप्त नहीं है। कुल औसत स्टोरेज थ्रूपुट 37 GB प्रति सेकंड तक पहुंचा, और GPU के एक साथ अनुरोध भेजने पर चरम मांग औसत की लगभग दोगुनी हो सकती थी।
एक ही समय में चल रहे स्टोरेज ऑपरेशनों की संख्या आम तौर पर करीब 160 थी, लेकिन अचानक बढ़कर 800 तक पहुंच सकती थी। सैमसंग का सुझाव है कि ऐसे उछाल संभालने और प्रतिक्रिया तेज़ बनाए रखने के लिए स्टोरेज बैंडविड्थ औसत जरूरत से कम से कम दोगुनी होनी चाहिए।
PM1753 की बताई गई अधिकतम क्रमिक थ्रूपुट गति 14.5 GB प्रति सेकंड और रैंडम रीड ऑपरेशनों की गति 3.3 मिलियन प्रति सेकंड तक है। परीक्षण के कार्यभार में स्टोरेज गतिविधि का करीब 92% रीड और 8% राइट था। LMCache ने लगभग 33 MB के बड़े कैश ब्लॉक स्थानांतरित किए।
कई सेवाएं एक साथ बड़े ब्लॉक पढ़ें, तो अनुरोधों की एक-दूसरे में गुंथी धारा बन सकती है। इसलिए स्टोरेज सबसिस्टम को उस समय भी स्थानांतरण प्रदर्शन बनाए रखना होगा, जब कई उपयोगकर्ता एक साथ सक्रिय हों। कैश क्षमता, स्थानांतरण की गति और शेड्यूलिंग, ये सभी तय करते हैं कि सहेजी गई जानकारी उपयोगी होने लायक तेजी से GPU तक पहुंचेगी या नहीं।
Samsung SDS गणना को मेमोरी के भीतर ले जाता है
Samsung SDS डेटा स्थानांतरण की समस्या से एक और तरीके से निपट रहा है। उसका PAISE शोध विवरण PIM-Accelerated Inference Scheduling Engine के बारे में बताता है, जिसे IEEE HPCA 2025 में पेश किया गया था। PAISE प्रोसेसिंग इन मेमोरी (PIM) का इस्तेमाल करता है। इस तकनीक में मेमोरी चिप के भीतर कंप्यूटिंग यूनिट लगाई जाती हैं, ताकि कुछ गणनाएं वहीं हो सकें जहां डेटा रखा है।
Samsung SDS ने सैमसंग के Aquabolt-XL PIM हार्डवेयर पर सिस्टम लागू कर उसका सत्यापन किया और GPT-2, OPT तथा Llama2 मॉडल का मूल्यांकन किया। कंपनी के मुताबिक, इन्फरेंस की गति में 48.3% तक सुधार हुआ और बिजली की खपत में लगभग 11.5% की कमी आई।
PAISE तय करता है कि कौन-से ऑपरेशन मेमोरी में चलने चाहिए और हार्डवेयर के अनुकूल डेटा व्यवस्थित करता है। यह छोटे अटेंशन गणनाओं को समूह में भी रखता है, ताकि वे समानांतर रूप से अधिक कुशलता से चल सकें। Samsung SDS के मुताबिक, इससे KV कैश अपडेट तेज़ हुए और बड़े बैच आकारों में अधिक सुधार मिला। बैच आकार का मतलब है साथ में प्रोसेस किए गए अनुरोधों के समूह।
तीनों परियोजनाएं सर्वर के अलग-अलग हिस्सों पर काम करती हैं। पेटेंट GPU और CPU मेमोरी के बीच अनुरोधों तथा डेटा स्थानांतरण को शेड्यूल करता है। स्टोरेज प्रयोग कैश को बाद में दोबारा इस्तेमाल के लिए ड्राइव पर सहेजता है। PAISE चुनिंदा गणनाओं को मेमोरी हार्डवेयर के भीतर ले जाता है। कुल मिलाकर, ये पहल दिखाती हैं कि एआई जवाबों के पीछे की जानकारी को स्थानांतरित करने या दोबारा तैयार करने में लगने वाला समय और ऊर्जा घटाने के लिए सैमसंग कई तरीके अपना रहा है।
मुख्य बातें
- सैमसंग का प्रकाशित पेटेंट आवेदन प्रतीक्षा समय, स्थानांतरण लागत और मेमोरी की अनुमानित जरूरतों के आधार पर एआई अनुरोधों को शेड्यूल करता है।
- पेटेंट वाली विधि का लक्ष्य मौजूदा GPU से अधिक उपयोगकर्ताओं को सेवा देना है; व्यावसायिक प्रदर्शन के आंकड़े सार्वजनिक नहीं किए गए हैं।
- सैमसंग के एक अलग स्टोरेज परीक्षण में एक साथ 240 उपयोगकर्ताओं तक के लिए शुरुआती जवाब की प्रतीक्षा एक सेकंड से कम रही। ऑफलोडिंग के बिना 140 से अधिक उपयोगकर्ताओं पर विलंबता बढ़ने लगी।
- 240 उपयोगकर्ताओं पर स्टोरेज ऑफलोडिंग से टोकन आउटपुट और लागत दक्षता लगभग 1.5 गुना रही, जबकि प्रति वॉट प्रदर्शन 2.9 गुना बेहतर हुआ।
- कम भार पर अतिरिक्त स्टोरेज से लागत करीब 4% बढ़ी, इसलिए आर्थिक गणना में मांग अहम है।
- Samsung SDS के मुताबिक, उसका अलग PAISE सिस्टम मेमोरी के भीतर गणना करके इन्फरेंस की गति में 48.3% तक सुधार लाया।