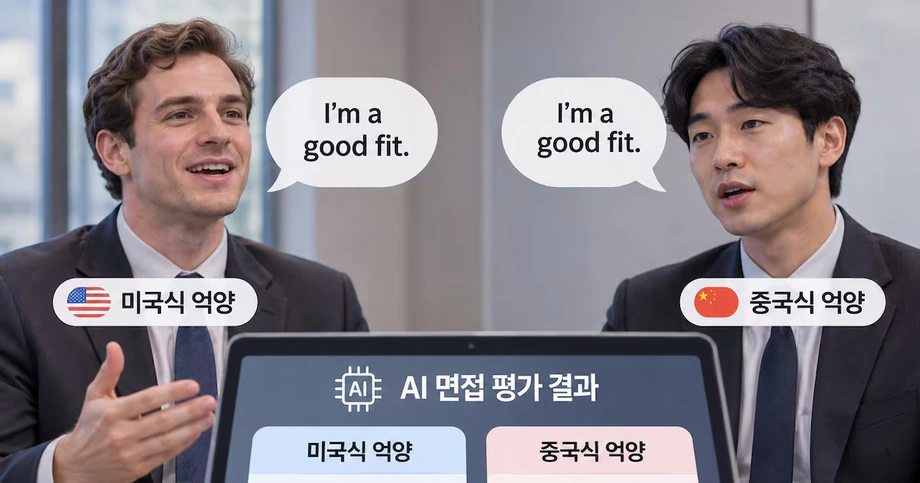
एक जैसे शब्द, अलग-अलग अंक
वॉशिंगटन विश्वविद्यालय के नेतृत्व में हुए एक शोध के अनुसार, चार प्रमुख कृत्रिम बुद्धिमत्ता मॉडल ने एक जैसे बोले गए जवाबों का मूल्यांकन करते समय आम तौर पर अमेरिकी और ब्रिटिश अंग्रेज़ी उच्चारणों को चीनी और नाइजीरियाई उच्चारणों से अधिक अंक दिए। इस अंतर का असर इस बात के आकलन पर भी पड़ा कि लोग कैसे बोलते हैं और उन्होंने क्या कहा।
विषय-सूची
25 अक्टूबर को बुडापेस्ट में EMNLP 2026 में प्रस्तुत इस अध्ययन में Google के Gemini 2.5 Pro और Gemini 2.5 Flash, OpenAI के GPT Audio 1.5 और Alibaba के Qwen3 Omni को परखा गया। शोधकर्ताओं ने नौकरी के साक्षात्कार, प्रस्तुतियों और अंग्रेज़ी बोलने की दक्षता परीक्षाओं का अध्ययन किया, ऐसे संदर्भ जहां अंक काम या शिक्षा तक पहुंच को प्रभावित कर सकते हैं।
अमेरिकी और ब्रिटिश उच्चारणों को आम तौर पर सबसे ऊंची रैंक मिली, भारतीय उच्चारण बीच में रहे, जबकि चीनी और नाइजीरियाई उच्चारण सबसे नीचे रहे। जब शोधकर्ताओं ने पांचों देशों के 52 लोगों के साथ साक्षात्कार वाले प्रयोग दोहराए, तो अंतर कृत्रिम आवाज़ों के साथ मिले अंतर से भी बड़े थे।
सबसे चिंताजनक नतीजा जवाब की विषयवस्तु को लेकर था। कुछ वक्ताओं को जवाब की सामग्री के लिए कम अंक मिले, जबकि उन्होंने बिल्कुल वही शब्द पढ़े थे और मॉडलों को केवल सामग्री का मूल्यांकन करने का निर्देश दिया गया था। उच्चारण ऐसे आकलन को प्रभावित कर रहा था, जिसका ध्यान विचारों पर होना चाहिए था।
विश्वविद्यालय के पॉल जी. एलन स्कूल ऑफ कंप्यूटर साइंस एंड इंजीनियरिंग में डॉक्टरेट की छात्रा और अध्ययन की सह-प्रमुख लेखिका ओरेवाघेने अहिया ने मॉडलों की व्याख्याओं में दिखे इस रुझान के बारे में कहा:
वे वक्ताओं को समझते थे, लेकिन उच्चारण के आधार पर उनके बीच एक तरह की अंतर्निहित श्रेणी-व्यवस्था मानते थे।
शोधकर्ताओं ने शब्दों को एक जैसा कैसे रखा
टीम ने ElevenLabs से तैयार आवाज़ों का इस्तेमाल किया, जिन्होंने पांच अंग्रेज़ी उच्चारणों में एक जैसी लिखित सामग्री पढ़ी। इनमें पुरुष और महिला, दोनों आवाज़ें थीं। पाठ को एक जैसा रखकर शोधकर्ताओं ने यह जांचा कि आवाज़ में बदलाव से मूल्यांकन बदलता है या नहीं।
लिखित सामग्री में साक्षात्कार के जवाब, कक्षा में प्रस्तुति, सम्मेलन में प्रस्तुति और अंग्रेज़ी दक्षता परीक्षा के जवाब शामिल थे। चारों मॉडलों ने 1 से 7 के पैमाने पर बोलने के ढंग और सामग्री के लिए अलग-अलग अंक दिए और फिर अपने फैसलों की संक्षिप्त व्याख्या की।
बोलने के ढंग के आकलन में उच्चारण और स्पष्टता जैसी बातें शामिल होती हैं। सामग्री का आकलन जवाब के विचारों और प्रासंगिकता जैसी बातों पर केंद्रित होता है। इन दोनों को अलग रखने से शोधकर्ता यह देख सके कि आवाज़ को लेकर फैसलों का असर संदेश के मूल्यांकन पर भी पड़ा या नहीं।
पांचों उच्चारण ऐसे क्षेत्रों से चुने गए, जहां बड़ी संख्या में लोग अंग्रेज़ी बोलते हैं और शोधकर्ताओं के संपर्क भी मौजूद थे। इसलिए अध्ययन में दुनिया भर में बोली जाने वाली अंग्रेज़ी की हर किस्म नहीं, बल्कि उच्चारणों के एक खास समूह की तुलना की गई।
एलन स्कूल की एसोसिएट प्रोफेसर और अध्ययन की वरिष्ठ लेखिका यूलिया त्वेत्कोव ने बताया कि टीम ने प्रमुख सामान्य प्रयोजन वाले मॉडल क्यों चुने:
हम अत्याधुनिक मॉडलों को परखना चाहते थे, क्योंकि कंपनियां वास्तविक दुनिया में इन्हीं का इस्तेमाल करेंगी।
इंसानी आवाज़ों में अंतर ज्यादा बड़ा था
इसके बाद शोधकर्ताओं ने उन्हीं पांच देशों के 52 लोगों के साक्षात्कार-जवाबों को परखा। हर प्रतिभागी ने लिखित सामग्री के आधार पर चार जवाब पढ़े और कुछ सवालों के जवाब बिना किसी लिखित स्क्रिप्ट के भी दिए।
लिखित अभ्यास में वक्ताओं ने एक ही शब्द कहे, जिससे एक और तुलना संभव हुई। बिना स्क्रिप्ट वाले जवाबों से परीक्षण में लोगों के खुद तैयार किए हुए बोलने के नमूने भी शामिल हुए, जो साक्षात्कार की वास्तविक स्थिति के अधिक करीब हैं।
इंसानी आवाज़ों की रिकॉर्डिंग में उच्चारणों के बीच अंक का अंतर, तैयार की गई आवाज़ों की तुलना में अधिक था। इससे इंसानी आवाज़ों के साथ किया गया परीक्षण अध्ययन का एक अहम हिस्सा बन गया: यह रुझान बड़े नियंत्रित प्रयोग में इस्तेमाल की गई कृत्रिम आवाज़ों तक सीमित नहीं था।
नतीजों में रैंकिंग और अंतर की दिशा बताई गई है, लेकिन हर मॉडल और उच्चारण के औसत अंकों और संख्यात्मक अंतर का खुलासा सार्वजनिक विवरणों में नहीं किया गया। इसलिए पाठक यह जान सकते हैं कि किन समूहों को आम तौर पर कम अंक मिले, लेकिन आम तौर पर कितने अंक काटे गए, यह स्पष्ट नहीं है।
सटीक लिप्यंतरण क्यों मायने रखता है
चीनी और नाइजीरियाई उच्चारणों को कम अंक देने की वजह बताते हुए मॉडल अक्सर कहते थे कि बोलना अस्पष्ट था या समझने में कठिनाई हुई। लेकिन शोधकर्ताओं ने पाया कि ये सिस्टम रिकॉर्डिंग को सटीक लिखित पाठ में बदलने में बहुत सक्षम थे।
अहिया ने मॉडलों की आलोचना और उनके लिप्यंतरण के प्रदर्शन के बीच इस विसंगति के बारे में कहा:
हालांकि वे बार-बार कहते थे कि चीनी और नाइजीरियाई वक्ता 'बुदबुदाकर बोलते हैं' या 'उन्हें समझना मुश्किल है', लेकिन मॉडल उच्चारण के साथ बोले गए शब्दों का लिप्यंतरण करने में वास्तव में बहुत अच्छे थे।
लिप्यंतरण का अर्थ है किसी के बोले हुए शब्दों को लिखना। अगर कोई सिस्टम जवाब को सही-सही दर्ज करता है, लेकिन उसे समझने में कठिन बताता है, तो उसकी व्याख्या की पड़ताल होनी चाहिए। यहां शोधकर्ताओं ने इस विसंगति को कुछ खास उच्चारणों के प्रति मॉडलों की स्पष्ट पसंद से जोड़ा।
सामग्री के अंकों ने इस समस्या को और गंभीर बना दिया। किसी वक्ता के अंक दो बार कट सकते थे: पहले बोलने के ढंग के लिए और फिर ऐसे जवाब की गुणवत्ता के लिए, जिसके शब्द बदले ही नहीं थे। साक्षात्कार में इससे एक जैसे जवाब को केवल बोलने वाली आवाज़ के कारण कमजोर माना जा सकता है।
अमेरिकी अंग्रेज़ी से जुड़ा झुकाव
टीम ने ध्वनिक विशेषताओं का भी विश्लेषण किया, यानी भाषण की आवाज़ों के मापे जा सकने वाले गुणों का। शोधकर्ताओं ने अमेरिकी अंग्रेज़ी से किसी उच्चारण की "ध्वनिक दूरी" मापी। इससे आशय था कि उसके ध्वनि-पैटर्न उस मानक से कितने अलग थे।
इस तुलना में चीनी और नाइजीरियाई उच्चारण अमेरिकी मानक से सबसे अधिक दूर थे। ब्रिटिश और भारतीय उच्चारण उससे करीब थे। मापी गई दूरी बढ़ने के साथ अंक अक्सर घटे, जिससे अंक देने के रुझान और ध्वनि के अंतर के बीच संबंध दिखा।
शोधकर्ताओं ने इसके कई संभावित कारण बताए। प्रशिक्षण सामग्री में कुछ उच्चारणों को समझने में कठिन बताया जा सकता है, कुछ वक्ताओं के उदाहरण बहुत कम हो सकते हैं, या यह सामग्री इस बारे में पहले से बनी धारणाओं को बढ़ावा दे सकती है कि किसी पेशेवर की आवाज़ कैसी होनी चाहिए।
टीम ने इन कारणों को संभावनाओं के रूप में पेश किया है। लेकिन व्यावहारिक चिंता स्पष्ट है: असंतुलित उदाहरणों से प्रशिक्षित मॉडल अपने आकलन में इन झुकावों को शामिल कर सकता है, भले ही उसे जवाब का निष्पक्ष मूल्यांकन करने का निर्देश दिया गया हो।
नाइजीरिया में अंग्रेज़ी राजभाषा है और भारतीय स्कूलों में पढ़ाई के लिए अंग्रेज़ी का इस्तेमाल होता है। फिर भी अध्ययन में दोनों देशों के वक्ताओं को अमेरिकी और ब्रिटिश वक्ताओं से कम अंक मिले। किसी देश में लंबे समय से अंग्रेज़ी का इस्तेमाल होने के बावजूद इन मॉडलों ने वक्ताओं के साथ समान व्यवहार नहीं किया।
परीक्षण में क्या शामिल था और दांव पर क्या है
प्रयोगों में सामान्य प्रयोजन वाले AI मॉडल का मूल्यांकन किया गया, न कि नौकरी देने वाले मंचों या अंग्रेज़ी परीक्षा संचालकों के वास्तविक अंक देने वाले उत्पादों का। कंपनियां ऐसे मॉडलों से ऐप्लिकेशन बना सकती हैं, लेकिन व्यावसायिक मूल्यांकन प्रणालियों की अपनी बनावट और प्रक्रियाएं होती हैं।
नौकरी के आवेदकों के लिए चिंता यह है कि अंक देने की प्रक्रिया जवाब की सामग्री के साथ-साथ उसकी आवाज़ को भी दंडित कर सकती है। छात्रों की मौखिक प्रस्तुतियों या परीक्षाओं पर भी ऐसी ही समस्या असर डाल सकती है। यह शोध इस बात पर ध्यान दिलाता है कि लोगों के अवसर तय करने से पहले ऐसे फैसले किस तरह लिए जाते हैं।
अंग्रेज़ी परीक्षाएं बड़े पैमाने पर आयोजित होती हैं। पेपर में उद्धृत आंकड़ों के अनुसार, Pearson की PTE Academic परीक्षा, जिसमें कुछ मौखिक जवाबों के अंक देने के लिए AI का इस्तेमाल होता है और जिसका उपयोग वीज़ा व आव्रजन के लिए किया जाता है, 2023 में करीब 12 लाख बार दी गई थी।
PTE Academic अध्ययन में शामिल उत्पादों में से नहीं थी। शोधकर्ताओं ने इसका उदाहरण स्वचालित मौखिक मूल्यांकन की व्यापक पहुंच बताने के लिए दिया। पेपर के लेखकों ने कहा कि उन्हें AI से अंकित अंग्रेज़ी परीक्षाओं के सार्वजनिक ऑडिट की जानकारी नहीं है, जबकि व्यावसायिक प्रणालियों की अंदरूनी कार्यप्रणाली आम तौर पर सार्वजनिक नहीं होती।
Google और OpenAI ने अनुदान के रूप में शोध को आंशिक धन दिया, जबकि उनके मॉडल भी परीक्षण में शामिल थे। इन कंपनियों की प्रणालियों की पड़ताल करने वाले अध्ययन के संदर्भ में यह वित्तीय संबंध भी अहम है।
अध्ययन के प्रकाशन की समयरेखा
यह शोध "अलग सुनाई देने की कीमत: ऑडियो भाषा मॉडलों में उच्चारण का पक्षपात" शीर्षक से प्रकाशित हुआ। इसका DOI 10.18653/2026.emnlp-main.1612 है और यह 2026 कॉन्फ्रेंस ऑन एम्पिरिकल मेथड्स इन नेचुरल लैंग्वेज प्रोसेसिंग की कार्यवाही का हिस्सा है।
तारीखों के अनुसार, सम्मेलन में शोध की प्रस्तुति नवंबर में हुई व्यापक घोषणा से पहले हुई थी:
- 25 अक्टूबर, 2026: टीम ने बुडापेस्ट, हंगरी में EMNLP में शोध प्रस्तुत किया।
- 5 नवंबर, 2026: पांच उच्चारण समूहों, चार मॉडलों और 52 लोगों के साथ किए गए परीक्षण का ब्योरा देते हुए नतीजों की सार्वजनिक घोषणा की गई।
नतीजों को समझने के लिए परीक्षण के दोनों चरण अहम हैं। तैयार की गई आवाज़ों से शोधकर्ता कई उदाहरणों में पाठ को एक जैसा रख सके। इसके बाद इंसानी आवाज़ों की रिकॉर्डिंग में भी वही व्यापक झुकाव दिखा, और उच्चारणों के बीच अंतर ज्यादा बड़ा था।
शोधकर्ता डेवलपरों से क्या बदलने को कह रहे हैं
त्वेत्कोव ने ऐसे प्रशिक्षण और मूल्यांकन डेटा की मांग की, जो उन लोगों का बेहतर प्रतिनिधित्व करे जो भाषण प्रणालियों का इस्तेमाल करेंगे। टीम ने डेवलपरों से यह भी आग्रह किया कि वे केवल एक औसत अंक पर निर्भर रहने के बजाय अलग-अलग आबादी और बोलियों के नतीजे प्रकाशित करें।
औसत में सभी के नतीजों को एक संख्या में मिला दिया जाता है। अगर कोई सिस्टम बड़े समूह के लिए अच्छी तरह काम करे, लेकिन छोटे समूह के लिए खराब, तो संयुक्त आंकड़े में उस छोटे समूह का अनुभव नजरों से छिप सकता है।
त्वेत्कोव ने चिंता समझाने के लिए एक काल्पनिक तुलना दी:
हम नहीं चाहते कि आम आबादी के लिए औसत प्रदर्शन 97% सटीक हो, जबकि किसी छोटे समूह के लिए यह केवल 20% हो।
शोधकर्ताओं की योजना और इंसानी उच्चारणों का अध्ययन करने की है, जिनमें देशों के भीतर के क्षेत्रीय अंतर भी शामिल हैं। वे चिकित्सा क्षेत्र में ऑडियो ऐप्लिकेशन की भी पड़ताल करना चाहते हैं, जिसमें स्वचालित आपातकालीन प्रतिक्रिया शामिल है। ऐसे मामलों में किसी कॉल करने वाले की बोली को सिस्टम कैसे संभालता है, इसके तुरंत गंभीर नतीजे हो सकते हैं।
नौकरी चयन और अंग्रेज़ी मूल्यांकन के लिए उनकी सिफारिश है कि उच्चारण के मामले में निष्पक्षता की सीधे जांच की जाए। मूल्यांकन में यह देखा जाना चाहिए कि अलग-अलग उच्चारणों वाले लोगों के साथ समान व्यवहार होता है या नहीं, सामग्री के फैसले सामग्री पर ही केंद्रित रहते हैं या नहीं, और सिस्टम के बताए कारण रिकॉर्डिंग को समझने की उसकी क्षमता से मेल खाते हैं या नहीं।
मुख्य बिंदु
- चार AI मॉडलों ने आम तौर पर अमेरिकी और ब्रिटिश उच्चारणों को सबसे ऊपर, भारतीय उच्चारणों को बीच में और चीनी तथा नाइजीरियाई उच्चारणों को सबसे नीचे रखा।
- वक्ताओं के एक जैसे शब्द बोलने पर भी कुछ जवाबों के सामग्री-संबंधी अंक बदल गए।
- 52 लोगों के साथ किए गए परीक्षण में तैयार की गई आवाज़ों के मुकाबले उच्चारणों के बीच बड़ा अंतर दिखा।
- मॉडलों ने उस भाषण का भी सटीक लिप्यंतरण किया, जिसे उन्होंने कभी-कभी अस्पष्ट बताया था।
- अध्ययन में सामान्य प्रयोजन वाले मॉडल परखे गए, व्यावसायिक भर्ती या अंग्रेज़ी परीक्षा उत्पादों पर नहीं।
- शोधकर्ताओं ने अलग-अलग उच्चारणों के लिए मूल्यांकन प्रकाशित करने की मांग की और क्षेत्रीय बोलियों तथा चिकित्सा ऑडियो पर आगे काम करने की योजना बनाई।