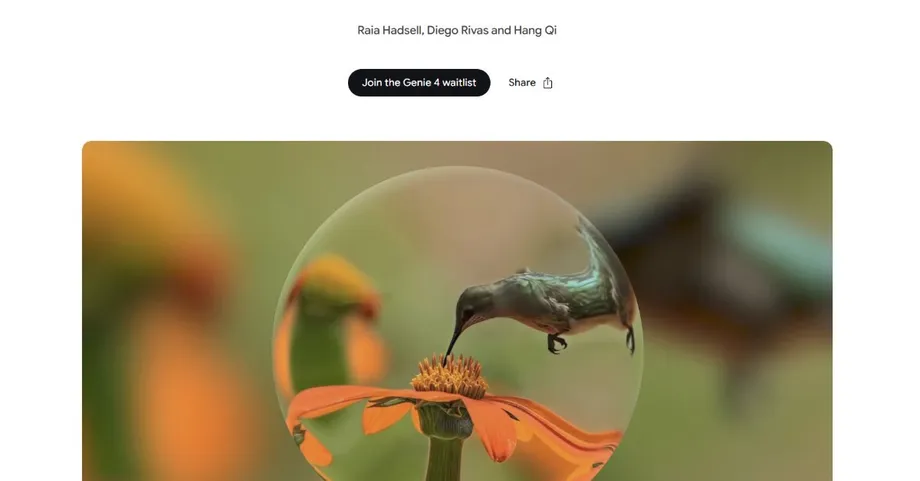
तस्वीरों, गतिविधियों और ध्वनि पर प्रतिक्रिया देने वाली आभासी दुनिया
Google DeepMind ने Genie 4 पेश किया है। यह एक प्रायोगिक कृत्रिम बुद्धिमत्ता मॉडल है, जो ध्वनि, बोले गए संवाद और बदलते भौतिक वातावरण वाली इंटरैक्टिव आभासी दुनिया बनाता है। अमेरिकी समयानुसार 27 अक्टूबर को घोषित यह मॉडल शुरुआत में भरोसेमंद परीक्षकों के एक छोटे समूह के लिए उपलब्ध है। आगे इसे Project Genie, Gemini API और Google AI Studio के जरिए उपलब्ध कराने की योजना है।
विषय-सूची
- तस्वीरों, गतिविधियों और ध्वनि पर प्रतिक्रिया देने वाली आभासी दुनिया
- इंटरैक्टिव दुनिया, तैयार वीडियो से कैसे अलग है
- ऑडियो पात्रों को संवाद का हिस्सा बनाता है
- Gemini योजना बनाता है, Genie दृश्य तैयार करता है
- Google रोबोटों को इसमें अभ्यास क्यों कराना चाहता है
- फिल्म की योजना बनाना अधिक तात्कालिक इस्तेमाल
- दो मिनट की निरंतरता अब भी एक कड़ी सीमा
- किसे मिलेगा इस्तेमाल का मौका और इसकी कीमत क्या होगी?
- Genie 3 से सिमुलेशन की व्यापक होड़ तक
- मुख्य बातें
Google का कहना है कि Genie 4 किसी दृश्य को दो मिनट तक एकसार बनाए रख सकता है। यह उसके पूर्ववर्ती Genie 3 के लिए बताई गई लगभग एक मिनट की अवधि से दोगुना है। इस दौरान उपयोगकर्ता किसी वातावरण में घूम सकते हैं, मौसम बदल सकते हैं, लोगों या वस्तुओं को शामिल कर सकते हैं और पात्रों को घटनाओं पर प्रतिक्रिया देते सुन सकते हैं।
Alphabet और Google के मुख्य कार्यकारी अधिकारी Sundar Pichai ने रिसर्च प्रीव्यू की घोषणा करते हुए इस मॉडल को बताया:
हमारा अब तक का सबसे यथार्थवादी और इंटरैक्टिव विश्व मॉडल
इसमें सबसे बड़ा नया बदलाव मूल रूप से शामिल ऑडियो है। इसका मतलब है कि ध्वनि को बाद में जोड़ने के बजाय, सिम्युलेट किए गए अनुभव के हिस्से के रूप में ही तैयार किया जाता है। दुनिया में बदलाव के साथ हवा, लहरों, पृष्ठभूमि संगीत और बातचीत की आवाजें सुनाई दे सकती हैं। Google का यह भी दावा है कि इंसानों की गतिविधियों और टकराव तथा वायुगतिकी जैसे भौतिक प्रभावों के सिमुलेशन में सुधार हुआ है। वायुगतिकी से आशय है कि हवा गतिशील वस्तुओं को कैसे प्रभावित करती है।
Google इस तकनीक को फिल्म की योजना बनाने, गेम विकसित करने, शिक्षा देने और रोबोटों या AI एजेंटों को वास्तविक वातावरण में काम करने से पहले प्रशिक्षित करने के लिए पेश कर रहा है। इसकी तात्कालिक सीमाएं भी व्यावहारिक हैं: दृश्य थोड़े समय तक ही चलते हैं, वस्तुएं अप्रत्याशित रूप से बदल सकती हैं, दृश्य के भीतर लिखे शब्द पढ़ना मुश्किल हो सकता है और ऑडियो की सटीकता की समस्या अभी बनी हुई है।
इंटरैक्टिव दुनिया, तैयार वीडियो से कैसे अलग है
Genie किसी लिखित विवरण या तस्वीर से शुरुआत करता है और ऐसा वातावरण बनाता है जिसे उपयोगकर्ता देख-परख सकते हैं। आम तौर पर तैयार किया गया वीडियो एक तय क्रम में चलता है, जिसे दर्शक देखते हैं। विश्व मॉडल उपयोगकर्ता की गतिविधियों के जवाब में आगे क्या होगा, यह लगातार बनाता रहता है।
कीबोर्ड से उपयोगकर्ता घूम सकते हैं और कैमरे की स्थिति तय कर सकते हैं। लिखित निर्देशों से चलते हुए वातावरण को बदला जा सकता है, जैसे मौसम बदलना, कोई पात्र जोड़ना या देखने का नजरिया बदलना। इसके बाद सिस्टम को इन बदलावों के मुताबिक अगली तस्वीरें बनानी होती हैं।
Google इसे अनुभव को फ्रेम-दर-फ्रेम तैयार करना बताता है। हर संभावित प्रतिक्रिया पहले से तैयार रखने के बजाय, मॉडल यह अनुमान लगाता है कि किसी व्यक्ति की गतिविधि के बाद दृश्य कैसे आगे बढ़ना चाहिए।
इसलिए निरंतरता बनाए रखना एक बड़ी चुनौती है। उपयोगी सिमुलेशन के लिए यह याद रखना जरूरी है कि वस्तुएं कहां हैं, लोग कैसे चल रहे हैं और अब तक क्या हुआ है। अगर उपयोगकर्ता के पीछे मुड़ने पर दृश्य का लेआउट बदल जाए, तो जो दृश्य एक पल पहले विश्वसनीय लग रहा था, वह कम उपयोगी हो जाता है।
ऑडियो पात्रों को संवाद का हिस्सा बनाता है
Genie 4 बदलती हुई इस दृश्य दुनिया में वातावरण की आवाजें, संगीत और बातचीत जोड़ता है। Google का कहना है कि ऑडियो तैयार किए जा रहे स्थान से मेल खा सकता है, जैसे पेड़ों के बीच से गुजरती हवा या किनारे से टकराती लहरें।
सिमुलेशन के भीतर उपयोगकर्ता के इनपुट और घटनाओं पर पात्र बोलकर प्रतिक्रिया भी दे सकते हैं। उनके संवाद तय साउंडट्रैक के बजाय, स्थिति के अनुसार बदलने के लिए बनाए गए हैं। उपयोगकर्ता अपने प्रॉम्प्ट में दृश्य और ऑडियो, दोनों तरह के तत्व बता सकते हैं।
Google का कहना है कि इंसानी आकृतियों में भी सुधार हुआ है: उनकी गतिविधियां अधिक स्वाभाविक हैं और वे आसपास के माहौल पर प्रतिक्रिया देती हैं। सिमुलेशन जारी रहने के दौरान उनकी गतिविधियों को निर्देशित किया जा सकता है, जिससे पात्रों के व्यवहार और दृश्य में बदलाव एक ही इंटरैक्शन का हिस्सा बन जाते हैं।
टीम ने माना है कि ऑडियो की सटीकता अभी विकास के दौर की समस्या है। किसी दृश्य या इंटरैक्टिव अभ्यास की योजना बनाने वाले व्यक्ति के लिए व्यावहारिक जरूरत यह है कि गतिविधि बदलने पर भी संवाद और वातावरण की आवाजें उपयुक्त बनी रहें।
Gemini योजना बनाता है, Genie दृश्य तैयार करता है
Google ने अपने Gemini AI मॉडल परिवार को Genie 4 के साथ और करीब से जोड़ा है। दोनों के काम अलग-अलग हैं: Genie सिम्युलेट की गई दुनिया बनाता है, जबकि Gemini घटनाओं को दिशा देने और यह जांचने में मदद करता है कि नतीजा तय योजना के अनुरूप है या नहीं।
Gemini Omni वातावरण की बनावट और व्यवहार में मदद करता है। Gemini 3.8 Flash आने वाले फ्रेम पर नजर रखता है, लक्ष्यों को छोटे चरणों में बांटता है, जांचता है कि गतिविधियां सफल हुईं या नहीं और दृश्य बदलने या उपयोगकर्ता के दखल देने पर योजना में बदलाव करता है।
सरल शब्दों में, सिस्टम का एक हिस्सा अगला दृश्य बनाता है, जबकि दूसरा लक्ष्य की दिशा में हुई प्रगति पर नजर रखता है। इस व्यवस्था का मकसद घटनाओं को तर्कसंगत क्रम में आगे बढ़ाना है, खासकर तब जब किसी काम में तुरंत प्रतिक्रिया के बजाय कई गतिविधियों की जरूरत हो।
Google के रिसर्च निदेशक Tejas Kulkarni ने एक ब्रीफिंग के दौरान कंपनी की दीर्घकालीन सोच का वर्णन किया:
भविष्य में हम तेजी से ऐसे हाइब्रिड विश्व मॉडल देखेंगे, जिनमें Gemini द्वारा कोड और टेक्स्ट लिखने और Genie द्वारा उसे रियल टाइम में लेकर अलग-अलग स्तरों पर वास्तविकता का सिमुलेशन करने का मेल होगा,
इस प्रस्तावित मेल से भाषा, कोड और दृश्य सिमुलेशन एक साथ काम कर सकेंगे। Genie 4 पहले से ही सीमित रूप में जिम्मेदारियों के इस बंटवारे का इस्तेमाल करता है: उपयोगकर्ता के दुनिया में घूमने के दौरान Gemini उसे दिशा देने में मदद करता है।
Google रोबोटों को इसमें अभ्यास क्यों कराना चाहता है
Google DeepMind यह परख रहा है कि Genie 4 रोबोटों और AI एजेंटों के लिए प्रशिक्षण का माहौल कैसे मुहैया करा सकता है। एजेंट ऐसा सॉफ्टवेयर है जो कोई लक्ष्य हासिल करने के लिए गतिविधियां चुनता है, उनके नतीजे जांचता है और तय करता है कि आगे क्या करना है।
Gemini Robotics से जुड़े एक प्रयोग में Gemini 4 Argon ने कामों को चरणों में बांटा, जिनका Genie 4 ने रियल टाइम में सिमुलेशन किया। इसका मकसद यह जानना है कि कोई रोबोट भौतिक दुनिया में किसी जटिल काम को करने की कोशिश से पहले उसे कैसे अंजाम दे सकता है।
Google का कहना है कि आभासी वातावरण में ऐसी स्थितियां दोबारा बनाई जा सकती हैं, जिनका वास्तविक दुनिया में सामना करना या उन्हें व्यवस्थित करना मुश्किल हो। डेवलपर हर बदलाव के लिए अलग भौतिक परीक्षण-स्थल बनाए बिना परिस्थितियां बदल सकते हैं और देख सकते हैं कि एजेंट कैसी प्रतिक्रिया देता है।
टकराव और वायुगतिकी में बताए गए सुधार इस इस्तेमाल के लिए खास तौर पर अहम हैं। प्रशिक्षण में किसी गतिविधि और उसके नतीजे के बीच उपयोगी संबंध होना चाहिए: उदाहरण के लिए, संपर्क के बाद कोई वस्तु कैसे चलती है या गतिविधि के जवाब में वातावरण कैसे बदलता है। Google ने माना है कि जटिल भौतिक गतिविधियां मॉडल के लिए अब भी चुनौती हैं।
फिल्म की योजना बनाना अधिक तात्कालिक इस्तेमाल
भरोसेमंद परीक्षकों ने फिल्म के शुरुआती नमूने तैयार करने और तेजी से स्टोरीबोर्ड बनाने को इसके संभावित इस्तेमालों में शामिल किया है। स्टोरीबोर्ड फिल्मांकन से पहले दृश्यों का क्रम तय करता है। Genie 4 से रचनात्मक टीम किसी विचार के आकार लेने के दौरान कैमरे की जगह, पात्रों की गतिविधियां और माहौल में बदलाव तलाश सकती है।
Google DeepMind के इंजीनियर Diego Rivas ने एक प्रेस ब्रीफिंग में बताया कि इस चरण में तुरंत प्रतिक्रिया क्यों उपयोगी हो सकती है:
रियल टाइम में काम करने की खूबी उन क्षेत्रों में सबसे ज्यादा काम आती है, जहां रचनात्मकता के दौरान प्रवाह बनाए रखना बेहद उपयोगी होता है,
Rivas ने विचार विकसित करने और स्टोरीबोर्ड बनाने को उदाहरण बताया। इसका व्यावहारिक लाभ तेजी है: किसी दृश्य को बदलकर उसका नतीजा देखा जा सकता है, और हर बदलाव के लिए अलग क्रम तैयार करने की जरूरत नहीं पड़ती।
Google Veo भी पेश करता है, जो प्रॉम्प्ट से सिंक्रोनाइज़्ड ऑडियो वाले वीडियो क्लिप बनाता है। Rivas ने भविष्य की एक संभावना बताई, जिसमें Gemini Omni शुरुआती नमूनों को रचनात्मक सामग्री में बदलने में मदद कर सकता है। हालांकि, उन्होंने कहा कि ऐसी क्षमताएं अभी दूर हैं।
गेमिंग और इंटरैक्टिव शिक्षा इसके अन्य प्रस्तावित इस्तेमाल हैं। इनमें समानता यह है कि दृश्य प्रतिभागी की गतिविधियों पर प्रतिक्रिया देता है, न कि मीडिया की तैयार सामग्री की तरह हर बार एक ही तरह से चलता है।
दो मिनट की निरंतरता अब भी एक कड़ी सीमा
Genie 4 की बताई गई दो मिनट की निरंतरता अवधि, Genie 3 की लगभग एक मिनट की सीमा से दोगुनी है। इससे उपयोगकर्ताओं को किसी विचार को तलाशने के लिए ज्यादा समय मिलता है, लेकिन लगातार चलने वाली गतिविधि की अवधि अब भी सीमित है।
Google का कहना है कि सिमुलेशन के चलते वस्तुएं और दृश्य के ब्योरे बदल सकते हैं। किसी वस्तु का रूप या जगह बदल सकती है और सिस्टम यह भूल सकता है कि दृश्य की शुरुआत कैसे हुई थी। इसलिए Gemini की निरंतरता बनाए रखने में मदद के बावजूद लंबे सत्र मुश्किल बने हुए हैं।
दुनिया के भीतर तैयार किया गया टेक्स्ट पढ़ने लायक भी नहीं हो सकता। इससे उन दृश्यों में ठोस समस्या पैदा होती है जिनमें संकेत, निर्देश या ऐसा कोई अन्य पाठ हो जिसे व्यक्ति को पढ़ना जरूरी है।
Google Genie 4 को शुरुआती प्रायोगिक मॉडल बताता है और अलग-अलग क्षेत्रों के परीक्षकों के साथ काम कर रहा है। Rivas ने कहा कि अंतिम उत्पाद का पूरा अनुभव कैसा होगा, यह अभी तय किया जा रहा है। फिलहाल इसका उपयोग छोटे प्रयोगों तक सीमित है। दृश्य की निरंतरता, भौतिक व्यवहार और ध्वनि, तीनों पर अभी और काम की जरूरत है।
किसे मिलेगा इस्तेमाल का मौका और इसकी कीमत क्या होगी?
Genie 4 का रिसर्च प्रीव्यू भरोसेमंद परीक्षकों के साथ शुरू हुआ है। Google की योजना Google AI Ultra के सब्सक्राइबरों के लिए Project Genie के जरिए आम उपयोगकर्ताओं की पहुंच बढ़ाने और Gemini API तथा Google AI Studio का इस्तेमाल करने वाली शुरुआती साझेदारियों के जरिए डेवलपरों को पहुंच देने की है।
Google ने इस विस्तार को जल्द होने वाला बताया है। इसे आने वाले हफ्तों में शुरू करने की उम्मीद है, लेकिन कोई पक्की तारीख नहीं दी गई है। Project Genie के लिए प्रतीक्षा सूची में नाम दर्ज किए जा रहे हैं। API से डेवलपर मॉडल को अपने सॉफ्टवेयर से जोड़ सकेंगे, जबकि AI Studio Google के मॉडल के साथ प्रयोग करने की जगह देता है।
Google AI Ultra प्लान की शुरुआती कीमत 100 डॉलर प्रति माह बताई गई है। Genie 4 के लिए डेवलपरों की अलग कीमत घोषित नहीं की गई है। AI Pro और AI Plus के जरिए पहुंच बढ़ाने पर बाद में विचार किए जाने की बात हुई है, लेकिन इसे लॉन्च की पुष्टि की गई व्यवस्था नहीं बताया गया है।
Google का कहना है कि तैयार किए गए वीडियो और ऑडियो पर SynthID होगा। यह AI से तैयार सामग्री की पहचान के लिए उसका डिजिटल वॉटरमार्क है। इन सिम्युलेट किए गए अनुभवों की पहुंच ज्यादा उपयोगकर्ताओं तक बढ़ने के साथ, इस चिह्न का मकसद सिस्टम से तैयार सामग्री की पहचान में मदद करना है।
Genie 3 से सिमुलेशन की व्यापक होड़ तक
Genie 4, Google के विश्व मॉडलों को रिसर्च डेमो से आगे ले जाने की दिशा में उठाए गए कई कदमों के बाद आया है:
- अगस्त 2025: Google DeepMind ने Genie 3 की घोषणा की।
- जनवरी 2026: Google ने Genie 3 का इस्तेमाल करते हुए Project Genie का परीक्षण शुरू किया।
- मई 2026: Google ने Street View के साथ इंटीग्रेशन की घोषणा की।
- अमेरिकी समयानुसार 27 अक्टूबर: Google ने Genie 4 और इसके शुरुआती रिसर्च प्रीव्यू की घोषणा की।
यह प्रतिस्पर्धा अब बिना आवाज वाले इंटरैक्टिव दृश्यों से भी आगे बढ़ रही है। Genie 4 से कुछ महीने पहले जारी Runway का GWM Worlds 2 उपयोगकर्ता की गतिविधियों पर प्रतिक्रिया देता है और ऑडियो भी तैयार करता है।
उद्योग में अन्य गतिविधियां भी AI विकास और भौतिक प्रणालियों, दोनों के लिए सिमुलेशन में रुचि का संकेत देती हैं। Rivian ने अपने वाहन परीक्षण के काम में सिमुलेशन क्षमताएं शामिल करने के लिए Third Dimension का अधिग्रहण किया है। World Labs के AMD द्वारा अधिग्रहण की खबरों और Decart को खरीदने के लिए Amazon की बातचीत से भी पता चलता है कि विश्व मॉडल तकनीक सौदों के एक व्यापक दौर का हिस्सा है। हालांकि, Amazon की ये चर्चाएं अभी बातचीत के स्तर पर हैं।
Google की इस नई पेशकश में दृश्य तैयार करना, संवाद और Gemini की योजना बनाने की क्षमता एक ही प्रायोगिक सिस्टम में जोड़ी गई है। अगला ठोस कदम ज्यादा लोगों को पहुंच देना है, जिससे अधिक रचनाकार और डेवलपर पता लगा सकेंगे कि मॉडल कौन-से छोटे काम भरोसेमंद ढंग से कर सकता है।
मुख्य बातें
- Google DeepMind ने अमेरिकी समयानुसार 27 अक्टूबर को Genie 4 की घोषणा की। शुरुआत भरोसेमंद परीक्षकों के साथ हुई।
- यह मॉडल वातावरण की आवाजों, संगीत और प्रतिक्रिया देने वाले बोले गए संवाद के साथ इंटरैक्टिव दुनिया बनाता है।
- Google का कहना है कि दृश्य की निरंतरता दो मिनट तक बनी रहती है, जो Genie 3 की लगभग एक मिनट की सीमा से दोगुनी है।
- Gemini मॉडल गतिविधियों की योजना बनाने, तैयार दृश्यों पर नजर रखने और सिमुलेशन में बदलाव करने में मदद करते हैं।
- इसके प्रस्तावित इस्तेमालों में फिल्म के स्टोरीबोर्ड, गेम, शिक्षा और रोबोटों का प्रशिक्षण शामिल है।
- वस्तुएं बदल सकती हैं, टेक्स्ट पढ़ने लायक नहीं हो सकता और जटिल भौतिकी तथा ऑडियो की सटीकता अब भी विकास की चुनौतियां हैं।
- Project Genie, Gemini API और Google AI Studio के जरिए पहुंच देने की योजना है। विस्तार की कोई पक्की तारीख या डेवलपरों के लिए कीमत घोषित नहीं की गई है।